Meta, Çok Modlu Ses Ayrıştırmada Yeni Bir Dönemi Başlatan SAM Audio Modelini Tanıttı

Meta, ses işleme teknolojilerinde önemli bir adım atan SAM Audio modelini kamuoyuna sundu. Şirket, daha önce görsel alanda öne çıkan Segment Anything Model yaklaşımını bu kez ses dünyasına uyarladı. Yeni model, karmaşık ses kayıtları üzerinde daha hassas kontrol sağlayan yapısıyla profesyonel kullanıma hitap ediyor. Meta, bu çalışmayla ses düzenleme süreçlerini daha anlaşılır bir noktaya taşımayı hedefliyor.
SAM Audio Ses Ayrıştırmayı Daha Doğal Bir Deneyime Taşıyor
Meta, SAM Audio modelini özellikle video, podcast, canlı kayıt gibi çok kaynaklı içeriklerde yaşanan ses karmaşasını çözmek için geliştirdi. Model, tek bir ses parçasına odaklanmak isteyen içerik üreticilerine doğal etkileşim yöntemleri sunuyor. Kullanıcı, klasik araçların aksine teknik ayarlara boğulmadan istediği sesi ayırabiliyor.

SAM Audio modeli, metin girdileri, görsel işaretler ile zaman aralıkları üzerinden ses segmentasyonu yapıyor. Kullanıcı, “vokal” ya da “köpek havlaması” gibi ifadelerle sistemle iletişim kurabiliyor. Model, bu komutlar doğrultusunda hedef sesi ayıklıyor. Video içeriklerinde ise ekrandaki bir enstrümana ya da konuşmacıya tıklamak yeterli oluyor. Zaman temelli yaklaşım, uzun kayıtlar boyunca tekrar eden istenmeyen seslerin temizlenmesini sağlıyor.
Bu yapı, sesle kurulan etkileşimi daha sezgisel hâle getiriyor. Meta, bu yaklaşımda insanın sesi algılama biçiminden ilham aldığını ifade ediyor. Şirket, teknik bilgi gereksinimini azaltan bu yöntemin ses düzenleme süreçlerini geniş kitlelere açtığını vurguluyor.
SAM Audio’nun merkezinde Perception Encoder Audiovisual adı verilen PE-AV motoru yer alıyor. Meta, bu altyapıyı daha önce açık kaynak olarak paylaşmıştı. Yeni sürüm, görsel ile işitsel verileri zaman ekseninde daha hassas biçimde eşleştiriyor. Sistem, bu sayede sahnedeki konuşmacıları, müzik aletlerini ya da ses kaynağına işaret eden nesneleri daha doğru analiz ediyor.
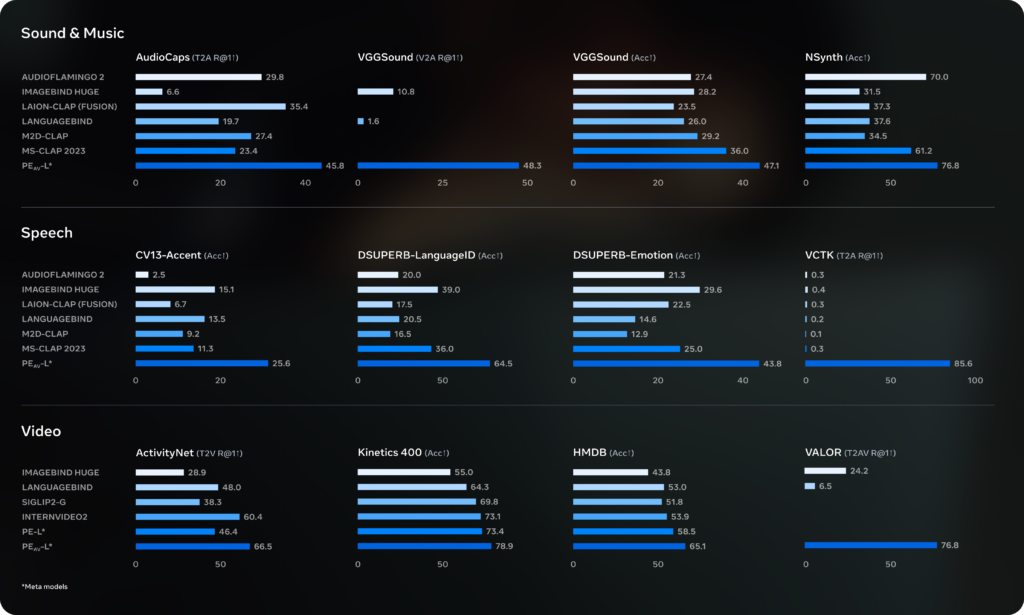
PE-AV motoru, yalnızca ekranda görülen unsurlarla sınırlı kalmıyor. Model, sahne bağlamını değerlendirerek ekran dışında gerçekleşen ses olayları hakkında da tahmin üretebiliyor. Bu özellik, özellikle canlı performans kayıtlarında fark yaratıyor.
Meta, SAM Audio’yu akış eşleştirme difüzyon dönüştürücüsü temelli bir üretici çerçeve üzerine inşa etti. Sistem, ses karışımını ortak bir temsil alanında işliyor. Ardından hedef ses ile geride kalan sesleri ayrı katmanlar hâlinde oluşturuyor. Eğitim sürecinde konuşma, müzik, çevresel sesler gibi geniş bir veri yelpazesi kullanıldı.
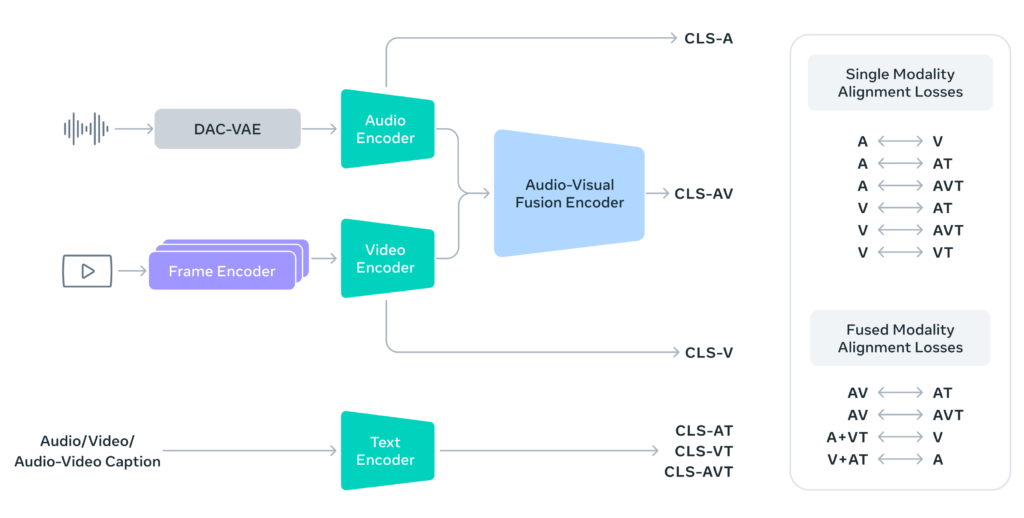
Gerçek kayıtların yanı sıra sentetik ses karışımları da eğitim sürecine dâhil edildi. Otomatik üretilen çok modlu ipuçları, modelin günlük kullanım senaryolarında daha istikrarlı sonuçlar vermesini sağladı. Meta, bu yöntemle gerçek dünya koşullarına uyum düzeyini artırdı.
SAM Audio, evrensel ses ayrıştırma testlerinde mevcut birçok modeli geride bırakıyor. Alanına özgü çözümlerle yapılan karşılaştırmalarda da güçlü sonuçlar elde ediliyor. Model, 500 milyon ile 3 milyar parametre arasında ölçeklenebiliyor. Gerçek zamanın altında çalışan yapı, profesyonel iş akışlarına uyum sağlıyor.
Model, sesin kendisini doğrudan bir komut olarak kabul etmiyor. Tamamen yönlendirmesiz bir ayrıştırma süreci de sunulmuyor. Ayrıca birbirine çok benzeyen seslerin ayrımı hâlen teknik bir zorluk oluşturuyor. Meta, bu sınırlamaların farkında olduğunu belirtiyor.
SAM Audio’nun sunduğu hassas ayrıştırma yetenekleri, bazı güvenlik sorularını da beraberinde getirdi. Model, kullanıcı isteğine göre belirli konuşmaları izole edebildiği için kamuya açık kayıtlardaki seslerin kötü niyetli amaçlarla ayrıştırılması ihtimali tartışılıyor. Meta, bu risklerin farkında olduğunu açıkladı. Şirket, ilerleyen süreçte kullanım politikaları üzerinde çalışacağını ifade etti. Modeli denemek isterseniz burayı indirmek isterseniz burayı tıklayabilirsiniz.