
High Cardinality Problemi: Observability Maliyetini ve Performansını Sessizce Nasıl Patlatıyor?
Yanlış label tasarımı, metrics altyapısında görünmeyen ama pahalı bir kırılma noktası oluşturabilir.
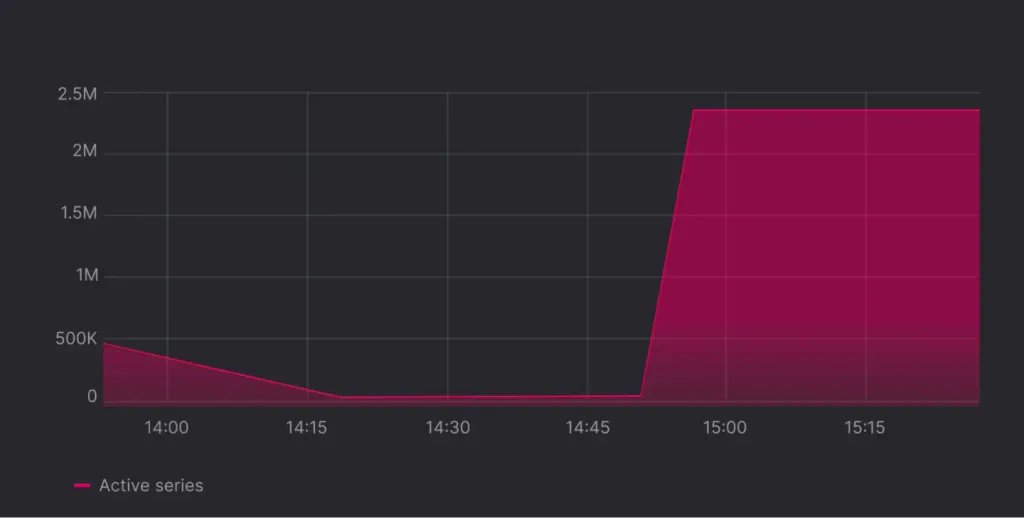
Observability tarafında çoğu ekip ilk olarak ne kadar veri topladığına bakıyor. Saniyede kaç metric geliyor, günlük kaç GB log üretiliyor, kaç trace saklanıyor gibi değerler doğal olarak maliyet ve kapasite hesabının bir parçası.
Fakat metrics tarafında daha az konuşulan başka bir değişken var: cardinality.
İşin ilginç tarafı şu; sisteminizde trafik ciddi şekilde artmadan, yeni bir sunucu eklemeden veya uygulama sayısını ikiye katlamadan da metric altyapınızın tükettiği kaynak bir anda büyüyebilir. Bunun sebebi bazen uygulamaya eklenen tek bir label’dır.
Örneğin bir geliştirici hata analizi kolaylaşsın diye metric içerisine user_id, session_id veya ham URL bilgisini ekler. İlk bakışta mantıklı görünür. Sonuçta daha fazla detay, daha fazla görünürlük sağlamalıdır.
Metrics dünyasında ise bu denklem her zaman böyle çalışmaz.
Bazen daha fazla detay, daha fazla observability değil; milyonlarca yeni time series anlamına gelir.
Önce cardinality’yi doğru tanımlayalım

Bir metric’i yalnızca metric adıyla düşünmemek gerekiyor.
Aşağıdaki metric’i ele alalım:
http_requests_total
Bu metric’e birkaç attribute eklediğimizi düşünelim:
method="GET"
status_code="200"
route="/checkout"
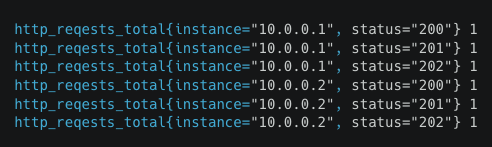
Ortaya şu tarz bir time series çıkar:
http_requests_total{
    method="GET",
    status_code="200",
    route="/checkout"
}
Aynı metric farklı bir HTTP metodu, response code veya route ile ölçüldüğünde başka bir attribute kombinasyonu oluşur.
Örneğin:
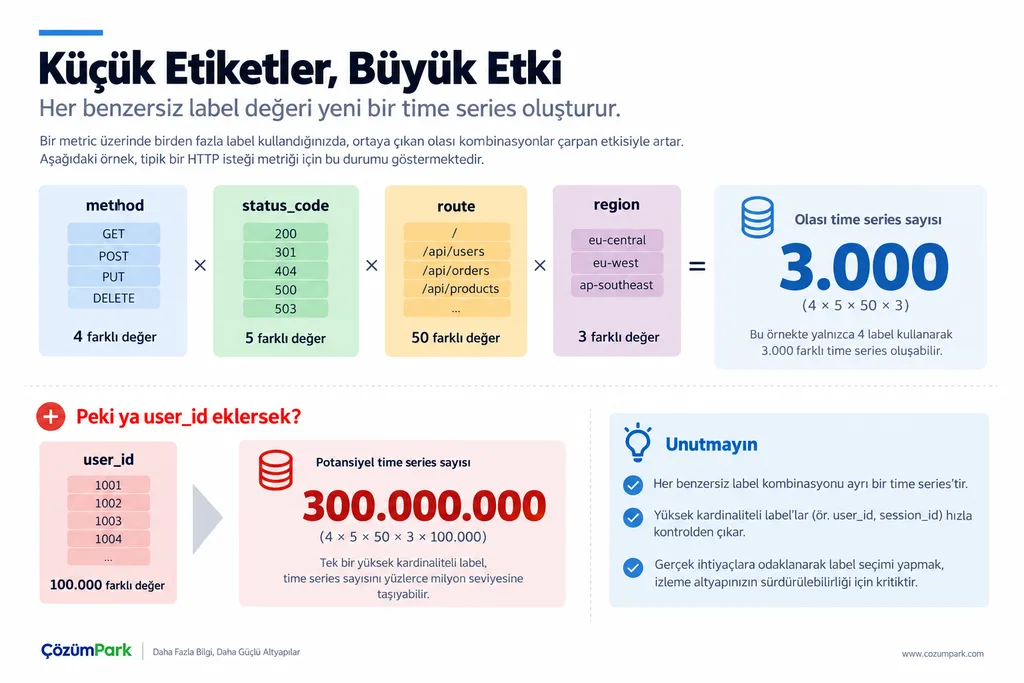
method        = 4 farklı değer
status_code   = 5 farklı değer
route         = 50 farklı değer
region        = 3 farklı değer
Teorik olarak:
4 × 5 × 50 × 3 = 3.000
farklı kombinasyon oluşabilir.
Buradaki önemli nokta cardinality’nin label sayısı olmamasıdır.
Cardinality, bir metric üzerinde oluşan benzersiz attribute/label kombinasyonlarının sayısıdır.
Prometheus tarafında da her benzersiz label set’i ayrı bir time series oluşturur ve label boyutları arttıkça cardinality’nin çarpan etkisiyle büyüyebileceği özellikle vurgulanıyor.
Şimdi aynı yapıya şunu ekleyelim:
user_id
Sistemde 100.000 farklı kullanıcı varsa teorik kombinasyon alanı artık:
4 × 5 × 50 × 3 × 100.000
seviyesine çıkabilir.
Her kombinasyonun gerçekten oluşması şart değil. Gerçek cardinality, sistemde gözlemlenen benzersiz kombinasyonlardan oluşur. Fakat problemi anlamak açısından çarpan etkisi kritik.
Bir label’ın kontrolsüz büyüyebilmesi bile metric tasarımını tamamen değiştirebilir.
High cardinality neden bu kadar problem yaratıyor?
Bir metric backend’i yalnızca gelen sayısal değeri saklamıyor.
Her farklı time series’in kimliğini, label set’ini ve zaman içerisindeki örneklerini de yönetmek zorunda.
Dolayısıyla cardinality arttıkça yalnızca disk kullanımı büyümüyor.
Aynı anda:
- metric SDK tarafındaki bellek tüketimi,
- ingestion yükü,
- network trafiği,
- aktif time series sayısı,
- index yükü,
- sorgu maliyeti,
- dashboard response süreleri
de etkilenmeye başlıyor.
Bu nedenle high cardinality problemi çoğu zaman storage problemi olarak başlasa bile operasyon tarafında query performance problemine dönüşebiliyor.
Grafana’nın güncel dokümantasyonunda da high-cardinality metric’lerin storage maliyetini artırdığı ve sorgu performansını etkileyebildiği açıkça belirtiliyor.
Burada dikkat edilmesi gereken başka bir detay daha var.
Request sayısının on kat artması ile cardinality’nin on kat artması aynı şey değil.
Bir counter’a aynı label set’iyle milyonlarca request yazabilirsiniz ve mevcut time series üzerinde aggregation devam eder.
Ancak her request’te yeni bir request_id üretip bunu label olarak eklerseniz neredeyse her request yeni bir series oluşturabilir.
Metrics tarafında esas risklerden biri tam olarak bu.
En tehlikeli label’lar genellikle en masum görünenler
High cardinality çoğu zaman karmaşık bir observability mimarisinden değil, instrumentation sırasında alınmış küçük bir karardan çıkıyor.
Örneğin şu attribute’lar dikkatle ele alınmalı:
user_id
session_id
request_id
email
transaction_id
device_id
timestamp
raw_url
exception_message
Bunların ortak noktası değer kümelerinin çok büyük veya doğrudan sınırsız olabilmesi.
Özellikle URL konusu sık karşılaşılan bir örnek.
Şunu metric attribute’u olarak saklamak:
/api/users/184592/orders/93812
ile şunu saklamak aynı şey değildir:
/api/users/{user_id}/orders/{order_id}
Birinci yapıda her kullanıcı ve sipariş kombinasyonu yeni bir route olarak görülebilir.
İkinci yapıda ise operasyon açısından anlamlı olan route korunurken değişken değerler normalize edilir.
Prometheus dokümantasyonu da user ID, e-mail gibi sınırsız büyüyebilecek değerlerin label içerisinde kullanılmaması gerektiğini özellikle belirtiyor.
Burada temel soru şu olmalı:
Bu dimension gerçekten metric üzerinde sorgulanmak zorunda mı?
Eğer cevap hayırsa o veri muhtemelen metric label’ı olmamalı.
“Ama bu bilgi incident sırasında lazım olabilir”
Bu itiraz haklı.
Bir kullanıcıya ait spesifik request’i araştırmak isteyebiliriz. Bir transaction’ın hangi serviste hata aldığını görmek veya belirli bir request’in tüm çağrı zincirini takip etmek gerekebilir.
Ancak bunun çözümü her bilgiyi metric içerisine taşımak değil.
Metrics, logs ve traces aynı problemi çözmek için tasarlanmış veri tipleri değildir.
Metric tarafında:
checkout_failure_total{
    region="eu",
    payment_method="card"
}
gibi bounded ve aggregation için anlamlı dimension’lar oldukça değerlidir.
Ama:
checkout_failure_total{
    user_id="847291",
    transaction_id="TRX-84920193"
}
gibi değerler genellikle log veya trace tarafında daha doğru bir yere sahiptir.
Metric size:
“Checkout failure rate son 10 dakikada yükseldi.”
diyebilir.
Trace veya log ise:
“Hangi transaction başarısız oldu ve request hangi servislerden geçti?”
sorusuna cevap verir.
Observability tasarımında sinyal tiplerinin birbirinin yerine kullanılmaya çalışılması veri hacmini çok hızlı şekilde büyütüyor.
Bu nedenle iyi bir telemetry pipeline’ın görevi yalnızca veri toplamak değildir.
Doğru veriyi doğru sinyal tipinde tutmaktır.
OpenTelemetry tarafında önemli bir koruma mekanizması var
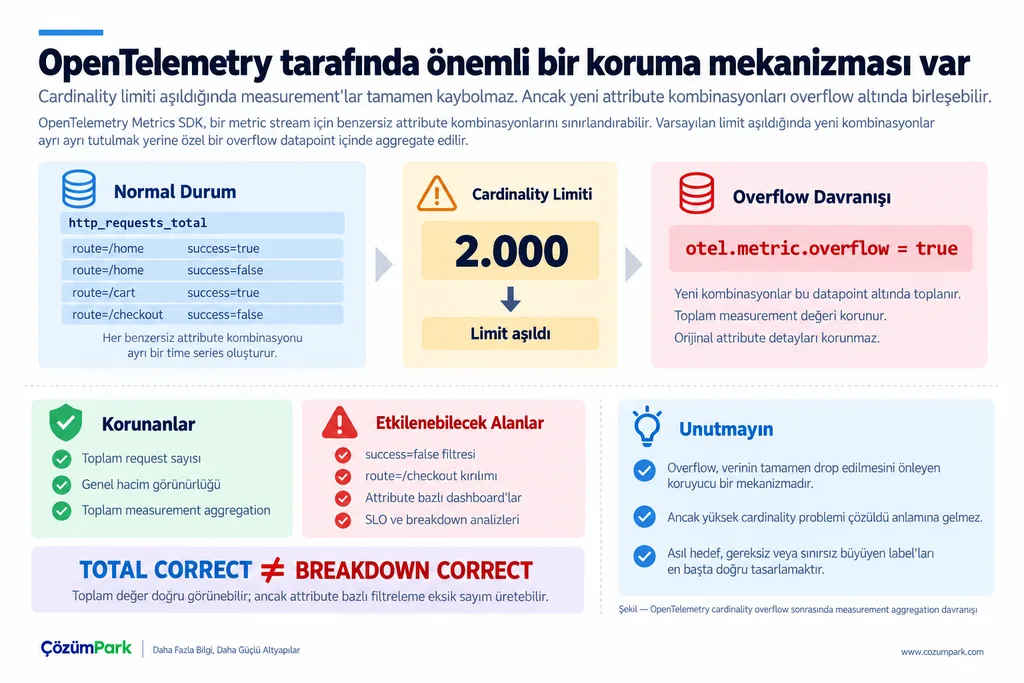
High cardinality konusu OpenTelemetry tarafında da ciddi şekilde ele alınıyor.
OpenTelemetry Metrics SDK spesifikasyonunda bir metric stream için cardinality limiti tanımlanabiliyor. Herhangi bir özel değer belirlenmediğinde önerilen varsayılan limit 2.000 benzersiz attribute kombinasyonu.
Buradaki mekanizma önemli.
Limit dolduğunda OpenTelemetry yeni measurement’ları basitçe çöpe atmıyor.
Yeni kombinasyonlar:
otel.metric.overflow=true
attribute’una sahip özel bir overflow data point içerisinde aggregate ediliyor.
İlk bakışta problem çözülmüş gibi görünebilir.
Aslında burada başka bir risk ortaya çıkıyor.
Örneğin normalde şöyle bir measurement geldiğini düşünelim:
{
    route="/checkout",
    success="false"
}
Cardinality limiti aşılmışsa bu measurement şu yapının içerisine girebilir:
{
    otel.metric.overflow="true"
}
Metric’in toplam değeri kaybolmaz.
Fakat orijinal attribute bilgileri artık yoktur.
Dolayısıyla:
toplam request sayısı
doğru görünmeye devam ederken,
success="false"
filtresi kullanan bir dashboard veya SLO sorgusu gerçekte olduğundan daha düşük bir sonuç gösterebilir.
OpenTelemetry’nin 6 Ağustos 2026’da yayımladığı cardinality rehberinde özellikle bu davranışa dikkat çekiliyor: overflow durumunda toplam measurement korunurken attribute bazlı filtreleme ve gruplama yapan sorgular eksik sayım yapabilir.
Bence high cardinality probleminin en kritik taraflarından biri bu.
Çünkü problem yalnızca faturada görünmeyebilir.
Dashboard doğru çalışıyor gibi görünürken veri kalitesi bozulmuş olabilir.
Cardinality limitini yükseltmek çözüm mü?
İlk refleks genellikle şu oluyor:
2.000 yetmiyorsa 10.000 yapalım.
Bazı senaryolarda bu doğru olabilir.
Ama limit artırmak high cardinality problemini otomatik olarak çözmez.
Önce neden limite ulaşıldığı anlaşılmalı.
Eğer sistemde gerçekten 4.000 adet operasyonel olarak anlamlı ve bounded combination varsa 2.000 limiti yetersiz olabilir.
Ancak cardinality şu tarz bir attribute nedeniyle büyüyorsa:
request_id
limiti 2.000’den 20.000’e çıkarmak yalnızca problemin ortaya çıkmasını geciktirir.
OpenTelemetry’nin güncel rehberi de overflow görüldüğünde ilk aksiyonun doğrudan limiti artırmak olmaması gerektiğini belirtiyor. Öncelikle attribute’un kontrolsüz veya yanlış instrumentation nedeniyle mi büyüdüğünün incelenmesi öneriliyor.
Ben burada üç ayrı senaryo görüyorum.
Birincisi, attribute gereksiz.
Metric’ten çıkarılmalı.
İkincisi, attribute gerekli fakat normalize edilebilir.
Raw URL yerine route template kullanılması gibi.
Üçüncüsü, high cardinality gerçekten iş gereksinimi.
Örneğin multi-tenant bir SaaS platformunda tenant bazlı SLO hesaplanması gerekiyorsa tenant_id operasyon açısından gerekli olabilir.
Bu durumda çözüm dimension’ı kör şekilde silmek değil; expected active set’in hesaplanması ve cardinality limitinin bilinçli tasarlanmasıdır.
Delta ve cumulative temporality burada fark yaratıyor
High-cardinality metric tasarımında gözden kaçan konulardan biri de temporality.
Basitleştirerek anlatırsak cumulative temporality bir metric’in aggregation state’ini zaman içerisinde taşımaya devam eder.
Delta temporality ise iki collection aralığı arasındaki değişimi raporlar.
Örneğin sisteminizde toplam bir milyon tenant olduğunu ancak herhangi bir 60 saniyelik collection interval içerisinde yalnızca 5.000 tenant’ın aktif olduğunu düşünelim.
Tenant dimension’ı kullanılıyorsa delta temporality açısından aktif combination set’i yönetilebilir olabilir.
Cumulative tarafta ise farklı tenant’lar zaman içerisinde görülmeye devam ettikçe tutulan aggregation state büyüyebilir.
OpenTelemetry de intentional high-cardinality kullanımında aktif set bounded ise delta temporality’nin bazı senaryolarda daha uygulanabilir olabileceğini belirtiyor.
Dolayısıyla cardinality yalnızca:
“Kaç label var?”
sorusu değildir.
Instrumentation modeli, aggregation biçimi ve telemetry lifecycle birlikte değerlendirilmelidir.
Peki high cardinality nasıl kontrol altına alınmalı?
Burada büyük bir teknoloji değişikliğinden önce metric tasarımını gözden geçirmek daha doğru.
İlk olarak mevcut metric’lerde hangi attribute’ların kullanıldığı çıkarılmalı.
Ardından her attribute için şu üç soru sorulabilir:
Bu attribute'un alabileceği değer sayısı bounded mı?

Bu dimension gerçekten dashboard, alert veya SLO içerisinde kullanılıyor mu?

Bu bilgi metric yerine log veya trace içerisinde tutulabilir mi?
Özellikle aşağıdaki kombinasyonlara dikkat etmek gerekiyor:
metric + user_id
metric + session_id
metric + request_id
metric + raw URL
metric + dynamically generated hostname
metric + arbitrary customer input
Daha sonra backend tarafında en fazla series üreten metric ve label’lar belirlenmeli.
Örneğin Prometheus tabanlı ortamlarda belirli bir metric için route cardinality’sini görmek adına benzer bir sorgu kullanılabilir:
count by (http_route) (
  {__name__="http_server_requests_total"}
)
Ancak çok büyük ortamlarda global cardinality analizi yapan sorguların kendisi de pahalı olabilir. Bu nedenle backend’in sunduğu native cardinality analysis veya usage dashboard’larını kullanmak daha kontrollü bir yaklaşım olacaktır.
Grafana gibi platformların artık doğrudan high-cardinality ve kullanılmayan time series’leri tespit etmeye yönelik ayrı maliyet yönetimi fonksiyonları sunması da problemin ne kadar operasyonel hale geldiğini gösteriyor.
Daha fazla telemetry her zaman daha fazla visibility değildir
Observability projelerinde ilk aşamada mümkün olduğunca fazla veri toplamak cazip geliyor.
Çünkü veri kaybetmek istemiyoruz.
Ancak sistem büyüdükçe farklı bir problem ortaya çıkıyor.
Artık soru:
“Hangi veriyi daha toplayabiliriz?”
olmaktan çıkıyor.
Şuna dönüşüyor:
“Topladığımız verinin ne kadarı gerçekten bir karar vermemizi sağlıyor?”
High cardinality bunun metrics tarafındaki en iyi örneklerinden biri.
Bir metric üzerinde 20 farklı dimension olması teorik olarak çok güçlü bir sorgulama kabiliyeti sağlayabilir.
Ancak bu dimension’ların büyük bölümü hiçbir dashboard, alert veya troubleshooting akışında kullanılmıyorsa sistem yalnızca kullanılmayan detay için compute, memory ve storage harcıyor.
Daha kötüsü, kontrolsüz bir attribute tüm metric pipeline’ın güvenilirliğini etkileyebiliyor.
Bu nedenle observability mimarisinde cardinality sonradan yapılacak bir maliyet optimizasyonu olarak görülmemeli.
Instrumentation tasarımının bir parçası olmalı.
Metric oluşturulurken yalnızca:
“Neyi ölçmek istiyorum?”
sorusu sorulmamalı.
Bir soru daha eklenmeli:
“Bu metric production ortamında kaç farklı time series üretebilir?”
Bu sorunun cevabı bilinmiyorsa metric’in maliyeti de aslında bilinmiyor demektir.
Observability’de asıl hedef mümkün olan en fazla telemetry’yi toplamak değil.
Problemi tespit etmek, anlamlandırmak ve aksiyon almak için gerekli telemetry’yi sürdürülebilir şekilde üretmek.
High cardinality konusu da tam olarak bu sınırın nerede çizileceğini gösteriyor.





Eline sağlık.