Kopyala, Yapıştır, Sızdır: Yedi Yıldır Herkese Açık Olan Gizli Verilerin Hikayesi: Paylaşılan Gizli Bilgiler, Türkiye’nin Maruziyeti

Yazılım geliştirme süreçlerinde kullanılan çevrimiçi JSON formatter ve benzeri veri biçimlendirme araçları, geliştiricilerin günlük iş akışlarının vazgeçilmez parçalarından biri haline gelmiştir. Hata ayıklama, veri doğrulama veya okunabilirliği artırma amacıyla kullanılan bu servisler çoğu zaman masum araçlar olarak değerlendirilmekte ve güvenlik açısından önemli bir risk unsuru olarak görülmemektedir.
Ancak son yıllarda yapılan araştırmalar, bu araçlara yüklenen verilerin yalnızca geçici olarak işlenmediğini, bazı durumlarda herkese açık şekilde saklandığını ve uzun süre erişilebilir durumda kaldığını ortaya koymaktadır. Özellikle üretim ortamlarından alınan JSON çıktıları, API yanıtları, hata kayıtları ve uygulama yapılandırmaları içerisinde yer alan hassas bilgiler; geliştiricilerin farkında olmadan üçüncü taraf sistemlere aktarılmasına ve kamuya açık hale gelmesine neden olabilmektedir.
Beyondmemory tarafından gerçekleştirilen bu araştırma, yaklaşık yedi yıllık bir dönemi kapsayan ve yüz binlerce kaydın incelendiği kapsamlı bir çalışma sonucunda ortaya çıkan bulguları içermektedir. Araştırma kapsamında yalnızca gizli anahtarlar, erişim belirteçleri ve altyapı bilgileri değil; aynı zamanda kişisel veriler, finansal kayıtlar, kimlik bilgileri ve Türkiye’deki çeşitli sektörlere ait hassas veriler de analiz edilmiştir.
Çalışmanın ortaya koyduğu sonuçlar, veri sızıntılarının yalnızca teknik güvenlik açıklarından kaynaklanmadığını, günlük operasyonel alışkanlıkların da ciddi riskler oluşturabildiğini göstermektedir. Ayrıca araştırma sırasında söz konusu platformlarda tespit edilen Stored Cross-Site Scripting (XSS) zafiyeti, bu servislerin yalnızca veri depolama açısından değil, aktif saldırı senaryoları açısından da değerlendirilmesi gerektiğini ortaya koymaktadır.
Klavye Başında Sıradan Bir Gün
Amerika Birleşik Devletleri’nde faaliyet gösteren bir vergi hazırlama şirketinde çalışan bir mühendis, belge teslimat sisteminde yaşanan bir hatayı incelemektedir.
Sorunu anlamak için debugger üzerinden elde ettiği JSON çıktısını kopyalar ve okunabilir hale getirmek amacıyla herkese açık bir JSON formatter servisine yapıştırır.
Bu JSON içerisinde:
- Müşterinin adı
- Sosyal Güvenlik Numarası (SSN)
- Bulut servislerine ait erişim anahtarları
- Sistem bağlantı bilgileri
yer almaktadır.
Mühendis yalnızca JSON’u düzenlemek istemektedir.
Ancak servis bu veriyi:
- Saklar
- Bir URL oluşturur
- URL’yi herkese açık “Recent Links” sayfasında yayınlar
Aylar sonra araştırmacılar bu veriyi herhangi bir kimlik doğrulaması olmadan indirebilmektedir.
Ne şirket bunu bilmektedir.
Ne müşteri.
Ne de büyük ihtimalle bilgi güvenliği ekibi.
Çünkü eğer biliyor olsalardı söz konusu veri hâlâ erişilebilir durumda olmazdı.
Aynı Senaryonun Türkiye’deki Karşılığı
Bu senaryoyu İstanbul’a, Ankara’ya veya İzmir’e taşıyalım. Bir geliştirici yine benzer şekilde bir JSON çıktısını biçimlendirmek amacıyla aynı servisi kullanmaktadır.
Bu kez JSON içerisinde:
- Bir banka müşterisinin kredi limiti
- Kalan borcu
- TL bakiyeleri
yer almaktadır.
Başka bir örnekte:
- GİB e-Fatura kayıtları
- Bir şirkete ait üye veritabanı
- Kimlik numaraları
- IBAN bilgileri
bulunmaktadır.
Kullanılan araç aynıdır. Geliştiricinin davranışı aynıdır. Sonuç da aynıdır. Veri geliştiricinin bilgisayarından çıktığı anda kontrol kaybedilmiştir.
Neden Bir JSON Formatter?
JSON formatter araçları teknik olarak son derece basittir. Metni alırlar, düzenlerler istenirse bir URL altında saklarlar. Ancak milyonlarca geliştirici hata ayıklama işlemleri sırasında üretim ortamlarından alınan gerçek verileri bu servislere yapıştırmaktadır. Sorunun temelinde de bu davranış yatmaktadır.
Önceki Araştırmalar
Kasım 2025’te watchTowr Labs yaklaşık 80.000 doküman üzerinde benzer bir çalışma gerçekleştirmişti.
Beyondmemory ise bu çalışmayı genişleterek:
- Yaklaşık 200.000 doküman
- Yaklaşık 7 yıllık zaman dilimi
- Mayıs 2026’ya kadar olan kayıtlar
üzerinde analiz gerçekleştirdi. Ayrıca yalnızca belgelerin varlığı değil, içeriklerinin ne olduğu da sınıflandırıldı. Bu çalışma sırasında daha önce görülmeyen yeni bir kategori ortaya çıktı: “Yapay zeka destekli yazılım geliştirme süreçlerinden kalan veriler.“
Tek Bir Site Değil
Araştırma yalnızca jsonformatter.org’u kapsamamaktadır.
Aynı işletmeci tarafından yönetilen:
- jsonformatter.org
- codebeautify.org
- diğer “beautifier” servisleri
ortak bir veri depolama altyapısını kullanmaktadır. Bir serviste oluşturulan bağlantı diğer servislerden de erişilebilir durumdadır. Araştırmacılar tüm bu servislerin ortak veri havuzunu analiz etti.
Temel Bulgular
Araştırma sonucunda:
- 1.078 belge yüksek güven seviyesinde gizli bilgi içeriyor
- 2.167 belge orta güven seviyesinde gizli bilgi içeriyor
tespit edildi.
Bu bilgiler arasında:
- API anahtarları
- Parolalar
- Kimlik bilgileri
- Erişim tokenları
- Kişisel veriler
yer almaktadır.
Araştırmacılar şu sonuca varmıştır: “Eğer hayatınızın herhangi bir döneminde prod ortamından alınmış bir JSON çıktısını internet üzerindeki bir formatter servisine yapıştırdıysanız, büyük ihtimalle bu veri setinde sizin de bir kaydınız bulunmaktadır.”
Veriler Nasıl Toplandı?
Araştırmacılar herhangi bir güvenlik önlemini aşmamıştır.
Her veri:
- Kimlik doğrulaması gerektirmeyen
- Herkese açık
- Servisin kendi arayüzünün kullandığı
API çağrıları üzerinden elde edilmiştir.
Recent Links Mekanizması
Servis şu yapıyı kullanmaktadır:
/recentLinksPage/json/0
/recentLinksPage/json/10
/recentLinksPage/json/20
Her sayfada 10 bağlantı listelenmektedir.
Her bağlantı:
abcdefgibi 6 karakterlik hexadecimal bir kimlik içerir.
Bu kimlik aşağıdaki API’ye gönderildiğinde:
POST /service/getDataFromIDorijinal içerik geri döndürülmektedir.
Güvenlik Kontrolleri
Araştırma sırasında:
- Kimlik doğrulama bulunmadı
- Token bulunmadı
- Session zorunluluğu bulunmadı
- Rate Limit bulunmadı
Araştırmacılara göre: Bir konut internet bağlantısı, birkaç dolarlık proxy bütçesi ve bir hafta sonu yeterlidir.
Analiz Süreci
200.000 belge manuel olarak incelenemeyeceği için çok aşamalı analiz yapıldı.
Birinci Aşama
Aranan veriler:
- API key
- Access token
- Connection string
- Kredi kartı numarası
- Şifreler
İkinci Aşama
Türk vatandaşlarına ait bilgiler tespit edildi.
Örnek doğrulamalar:
- TCKN checksum doğrulaması
- IBAN MOD-97 doğrulaması
Üçüncü Aşama
Belgenin Türkiye ile ilişkisi araştırıldı.
Örneğin:
- .tr alan adları
- Türkçe içerikler
- Türk Lirası tutarları
- Türk banka kodları
incelendi.
watchTowr Canary Testi
watchTowr Labs tarafından yapılan testte sisteme sahte bir erişim anahtarı yerleştirildi. 48 saat içerisinde üçüncü taraflar tarafından erişildiği gözlemlendi. Bu durum kamuya açık veri havuzlarının aktif olarak takip edildiğini göstermektedir.
Sızdırılan Veriler
Araştırmacılar çok sayıda farklı veri türü buldu.
Örnekler arasında:
- AWS erişim anahtarları
- Google AI API anahtarları
- SendGrid API anahtarları
- MongoDB bağlantıları
- Azure Service Bus erişim bilgileri
- JWT tokenları
- SSH anahtarları
- RSA private key’ler
- Stripe ödeme anahtarları
- OAuth tokenları
- Active Directory yapılandırmaları
- Kerberos ayarları
- Sosyal Güvenlik Numaraları
- Pasaport verileri
- TCKN ve IBAN kayıtları
bulunmaktadır.
Sızdırılan Veriler: Gerçek Vakalar
Araştırma kapsamında elde edilen belgeler yalnızca teknik yapılandırma dosyalarından ibaret değildir. İncelenen içerikler arasında finansal kayıtlar, sağlık verileri, kimlik bilgileri, bulut erişim anahtarları ve kurum içi sistem kayıtları da bulunmaktadır.
Yayın öncesinde tüm örneklerde yer alan:
- API anahtarları
- Erişim tokenları
- Kimlik numaraları
- Kredi kartları
- Telefon numaraları
- E-posta adresleri
- IBAN bilgileri
- Adres bilgileri
tamamen maskelemiştir. Araştırmacılar yalnızca sızıntının boyutunu gösterecek bilgileri paylaşmıştır.
Aynı Belge İçerisinde Dört Farklı Gizli Bilgi
İncelenen örneklerden birinde tek bir yapılandırma dosyasında aşağıdaki bilgiler yer almaktadır:
- AWS erişim anahtarı
- Veritabanı bağlantı bilgileri
- Google AI API anahtarı
- SendGrid API anahtarı
Araştırmacılara göre bu kayıt büyük ihtimalle yapılandırma dosyasındaki küçük bir hatayı düzeltmeye çalışan bir geliştirici tarafından paylaşılmıştır.
Ancak hata ayıklama amacıyla yüklenen dosya, herkese açık olarak yıllarca erişilebilir durumda kalmıştır.
Gerçek Kullanıcıya Ait Aktif Oturum Tokenı
Bir başka örnekte başarılı bir giriş işlemine ait API cevabı paylaşılmıştır.
Bu cevap içerisinde:
- Kullanıcı bilgileri
- İletişim bilgileri
- Aktif erişim tokenı
- MongoDB bağlantı bilgileri
yer almaktadır.
Araştırmacılar örnek olarak bazı tokenları analiz etmiş ve bunların sahte test verileri olmadığını doğrulamıştır.
Tokenlar:
- Geçerli issuer bilgileri
- Geçerli subject bilgileri
- Geçerlilik süreleri
içermektedir.
Araştırmacılar etik sebeplerle bu tokenları canlı sistemlerde kullanmamıştır.
Veri Koruma Şirketinin Kendi Bulut Anahtarı
İronik örneklerden biri bir veri koruma ve yedekleme şirketine aittir.
Şirketin Google Cloud entegrasyonu sırasında kullanılan yapılandırma bilgileri herkese açık şekilde paylaşılmıştır.
Belgede:
- Service Account bilgileri
- Client Email
- PrivateKeyId
- ClientPrivateKey
yer almaktadır.
Başka bir ifadeyle şirketin kendi bulut erişim bilgileri kamuya açık hale gelmiştir.
Bir Vatandaş Hakkında Hazırlanmış Araştırma Dosyası
Araştırmacılar en dikkat çekici örneklerden birinin ticari geçmiş araştırma raporu olduğunu belirtmektedir.
Bu belgede tek bir kişi için:
- Ev adresleri
- Telefon numaraları
- Komşu kayıtları
- Mülk bilgileri
- Oy kullanma kayıtları
- Lisans bilgileri
- Geçmiş adres bilgileri
yer almaktadır.
Herhangi bir sistem hacklenmemiştir.
Bir kullanıcı ücretli hizmet üzerinden elde ettiği raporu okumayı kolaylaştırmak amacıyla formatter servisine yüklemiştir.
Sonuç olarak son derece detaylı kişisel profil herkese açık hale gelmiştir.
Vergi Beyannamesi ve Bulut Anahtarı Aynı JSON İçerisinde
Amerika’daki bir vergi hazırlama sistemine ait belgede:
- Müşterinin adı
- Sosyal Güvenlik Numarası
- Azure Service Bus anahtarı
aynı kayıt içerisinde bulunmaktadır.
Araştırmacılar bu örneği: Kimlik bilgileri ve altyapı erişim bilgilerinin aynı anda sızdırılması
olarak değerlendirmektedir.
Küresel Bir Bordro Platformunun Özel API Anahtarı
Bir insan kaynakları ve bordro hizmet sağlayıcısına ait entegrasyon kaydında:
- İstemci sertifikası
- Özel anahtar
- Servisler arası iletişim kimlik bilgileri
tespit edilmiştir.
Bu bilgiler normal şartlarda kurum içi sistemlerin birbirleriyle güvenli iletişim kurmasını sağlamaktadır.
Avrupa Birliği Düzenleyici Kurumuna Ait Ticket Kaydı
Araştırmacılar bir Avrupa Birliği düzenleyici kurumunun dahili servis masası kaydını da tespit etmiştir.
Kayıtta:
- İş emri numaraları
- Süreç durumları
- İnceleyen personel bilgileri
- Bağlantılı işler
yer almaktadır. Doğrudan bir parola sızıntısı olmamasına rağmen kurumun işleyişi hakkında önemli bilgiler ortaya çıkmaktadır.
Büyük Bir Amerikan Bankasına Ait Jira Kaydı
Araştırma kapsamında büyük bir finans kuruluşunun Jira sisteminden alınmış kayıtlar da bulunmuştur.
Bu belgelerde:
- Proje kodları
- Süreç geçmişleri
- Dahili URL’ler
- Çalışan bilgileri
- Özel alanlar
yer almaktadır. Bazı belgelerde yüzlerce farklı alanın doldurulduğu görülmüştür.
Görsel Olarak Yayınlanmayan Diğer Örnekler
Araştırmacılar bazı örnekleri etik nedenlerle ekran görüntüsü olarak paylaşmamıştır.
Kablo Operatörü Müşteri Kayıtları
Bir telekom şirketine ait müşteri kayıtlarında:
- Adresler
- Posta kodları
- Müşteri numaraları
- İletişim tercihleri
yer almaktadır. Herhangi bir parola bulunmamasına rağmen bu veriler regülasyonlar açısından kritik kabul edilmektedir.
Askeri Hastaneye Ait Personel Kaydı
Bir çalışan kaydında:
- Ad
- Soyad
- Doğum tarihi
- Ulusal kimlik numarası
- Ev adresi
- Çalıştığı birim
- Base64 formatında fotoğraf
tespit edilmiştir. Araştırmacılara göre çalışan öğle arasından döndükten sonra hata ayıklama amacıyla bu verileri paylaşmıştır.
Küresel Bir Bankanın Kaynak Kod Envanteri
Bir başka belgede bankanın dahili geliştirme altyapısına ait bilgiler yer almaktadır.
Örneğin:
- Repository isimleri
- Proje kodları
- Development ve Production işaretleri
- Jira bağlantıları
gibi bilgiler bulunmaktadır. Tek başına kritik görünmese de saldırganlar için oldukça değerli keşif verileridir.
Genel Tablo
Araştırmanın ortaya çıkardığı asıl sorun tekil örnekler değildir. Sorun, bu örneklerin binlerce kez tekrar ediyor olmasıdır.
İncelenen veri setinde;
Bulut Anahtarları
- AWS
- Cloudflare
- Datadog
- PagerDuty
- Twilio
anahtarları tespit edilmiştir.
Özel Anahtarlar
- RSA Private Key
- SSH Private Key
- SSH Authorized Keys
tespit edilmiştir.
Veritabanı Bilgileri
- SQL bağlantıları
- MongoDB URI’leri
- AMQP bağlantıları
- Kullanıcı adı ve şifreler
bulunmuştur.
Ödeme Sistemleri
- Stripe anahtarları
- Ödeme servis sağlayıcı kimlik bilgileri
- SendGrid erişim bilgileri
tespit edilmiştir.
İş Akışı Verileri
- Jira
- Bitbucket
- OAuth Tokenları
- JWT verileri
yer almaktadır.
Yapay Zeka Servisleri
- OpenAI API Key
- Google AI Key
- Diğer LLM servislerine ait erişim anahtarları
tespit edilmiştir.
Kimlik Bilgileri
- Sosyal Güvenlik Numaraları
- Pasaport bilgileri
- Active Directory kayıtları
- Kerberos yapılandırmaları
- TCKN
- IBAN
bilgileri de veri seti içerisinde yer almaktadır.
Türkiye Bölümü Başlıyor
Araştırmanın en dikkat çekici kısımlarından biri Türkiye ile ilgili verilerin analizidir. Araştırmacılar başlangıçta Türkiye’nin diğer ülkelere göre daha ağır etkilendiğini düşünmüş ancak detaylı inceleme sonucunda farklı bir tablo ortaya çıkmıştır.
Türkiye özelinde:
- 2.087 Türkçe belge
- 800 kişisel veri içeren belge
- 262 doğrulanmış TCKN
- 40 doğrulanmış IBAN
- 18.019 telefon numarası
tespit edilmiştir. Ancak detaylı inceleme sonucunda bunların önemli kısmının pf olduğu görülmüştür.
Türkiye Bölümü: Gerçek Bulgular
Araştırmacılar ilk tarama sonuçlarının önemli bir bölümünün pf üretmesi nedeniyle tüm Türkçe içerikleri tek tek incelemiştir.
Örneğin:
- Apple finans verileri içerisindeki bazı alanlar TCKN olarak algılanmıştır.
- Bazı yabancı sistemlerdeki sayısal değerler telefon numarası olarak yorumlanmıştır.
- “Turkey” kelimesi nedeniyle Türkiye ile ilgisi olmayan sistemler Türk kaynağı olarak sınıflandırılmıştır.
Bu nedenle araştırma ekibi yalnızca gerçekten Türkiye ile ilişkili kayıtları değerlendirmeye almıştır.
Değerlendirme kriterleri:
- Türkçe içerik
- .tr alan adları
- Türk Lirası kayıtları
- Türk banka kodları
- Türkiye’ye ait kurum isimleri
olmuştur. Filtreleme sonrasında geriye daha küçük ancak tamamen gerçek bir veri kümesi kalmıştır.
Vaka 1: Bir Vatandaşın Tüm Kimliği Tek Bir JSON İçerisinde
Araştırmacılar otomotiv ve tüketici finansmanı sektörüne ait bir uygulamadan alınmış bir kayıt tespit etmiştir.
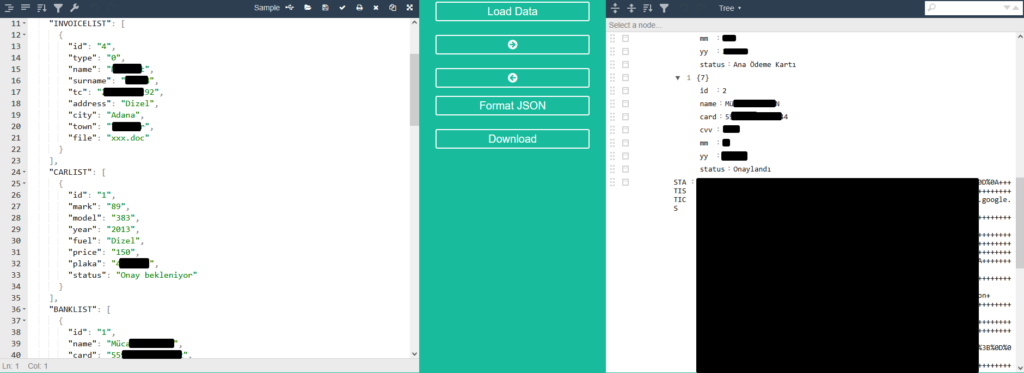

Belgede aynı kişi için:
- Ad
- Soyad
- TCKN
- İkamet ettiği şehir
- Araç bilgileri
- Araç plakası
- Başvuru durumu
yer almaktadır. Ancak asıl dikkat çekici bölüm ödeme kartlarıdır.
JSON içerisinde:
- Kart numarası
- CVV bilgisi
- Son kullanma tarihi
- Kart sahibi adı
yer almaktadır. Üstelik birden fazla kart aynı kayıt içerisinde bulunmaktadır. Araştırmacılar bu örneği şu şekilde değerlendirmiştir: Tek bir URL üzerinden bir kişinin kimliği, aracı ve ödeme araçları birlikte erişilebilir durumdadır.
Vaka 2: Meslek Odasına Ait Sertifika Kayıtları
Bir başka belgede Türkiye’deki meslek kuruluşlarından birine ait sertifika kayıtları tespit edilmiştir.
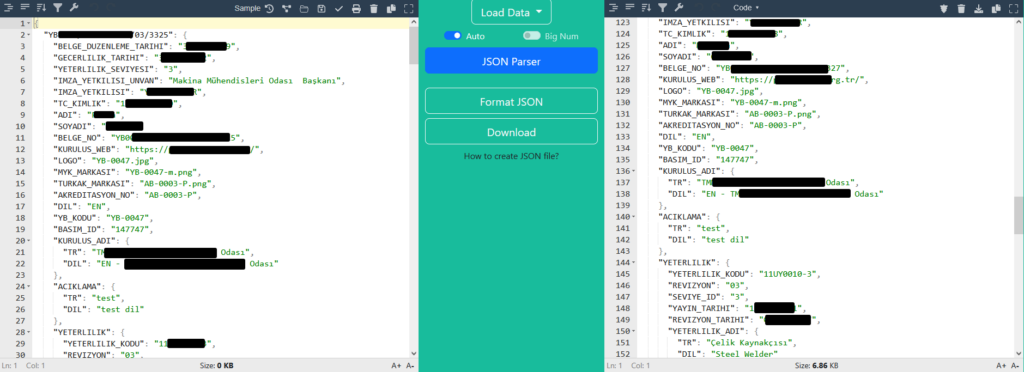
Kayıtlarda:
- Çelik kaynakçısı sertifikaları
- MYK akreditasyon bilgileri
- TÜRKAK referansları
- Sertifika sahiplerinin isimleri
- TCKN bilgileri
yer almaktadır.Belge bir şablon değil, gerçek veriler içermektedir. Araştırmacılar çok sayıda kişinin bilgilerinin kayıt içerisinde bulunduğunu belirtmektedir.
Vaka 3: Instagram Mesajlaşmasından Sızan Kişisel Bilgiler
Bu olay herhangi bir kurumsal sisteme ait değildir. Bir kullanıcı Instagram yazışmalarının çıktısını formatter servisine yüklemiştir.
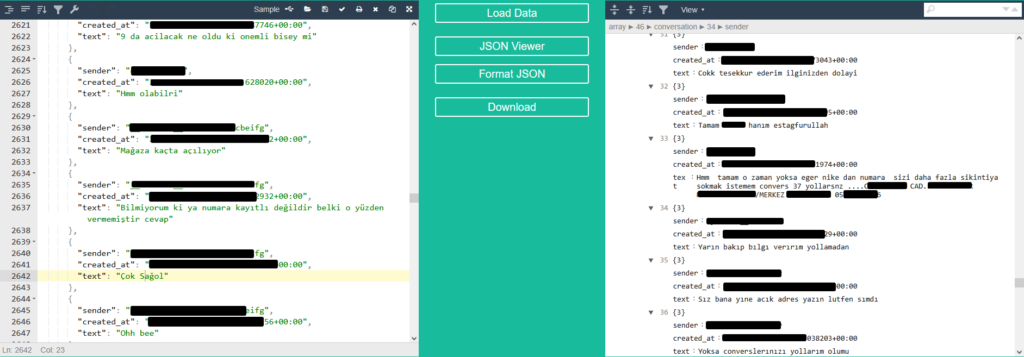
Mesajlaşma sırasında gerçekleştirilen bir ayakkabı siparişinde:
- Ad Soyad
- Telefon numarası
- Ayakkabı numarası
- Açık adres
paylaşılmıştır.
Araştırmacılar adresin mahalle ve bina numarasına kadar detay içerdiğini belirtmektedir.Bu örnek herhangi bir veri ihlali sonucu oluşmamıştır. Kullanıcı veriyi kendisi paylaşmıştır. Ancak sonuç değişmemiştir. Veri herkese açık hale gelmiştir.
Vaka 4: Sigorta Poliçesi
Araştırmacılar Türkiye’de faaliyet gösteren bir sigorta şirketine ait poliçe oluşturma kayıtları bulmuştur.
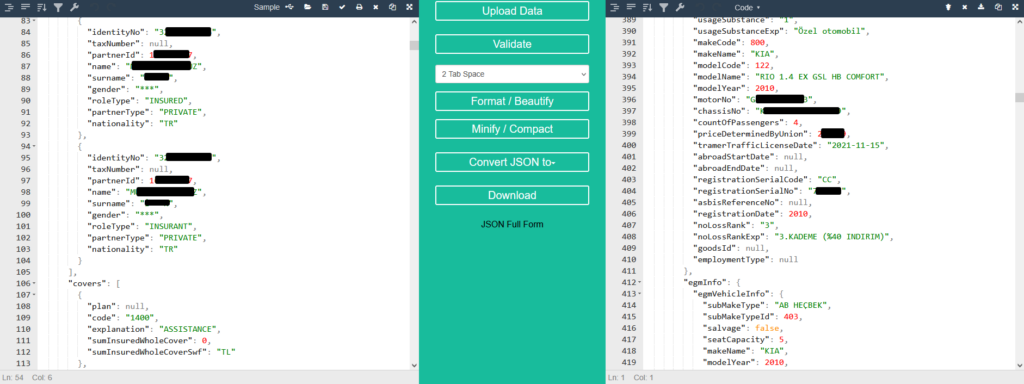
Belgede:
- Poliçe primi
- Komisyon tutarı
- Vergi bilgileri
- Sigorta bedeli
- Acente kodu
- Ödeme yöntemi
yer almaktadır.
Ayrıca sigortalı kişiye ait:
- TCKN
- Ad
- Soyad
bilgileri de kayıt içerisinde bulunmaktadır. Araştırmacılar aynı kaydın birden fazla kez sisteme yüklendiğini tespit etmiş ve bunun periyodik çalışan bir entegrasyonun çıktısı olduğunu değerlendirmiştir.
Vaka 5: GİB e-Fatura Kayıtları
Araştırma kapsamında Gelir İdaresi Başkanlığı e-Fatura sisteminden elde edilmiş kayıtlar da bulunmuştur.
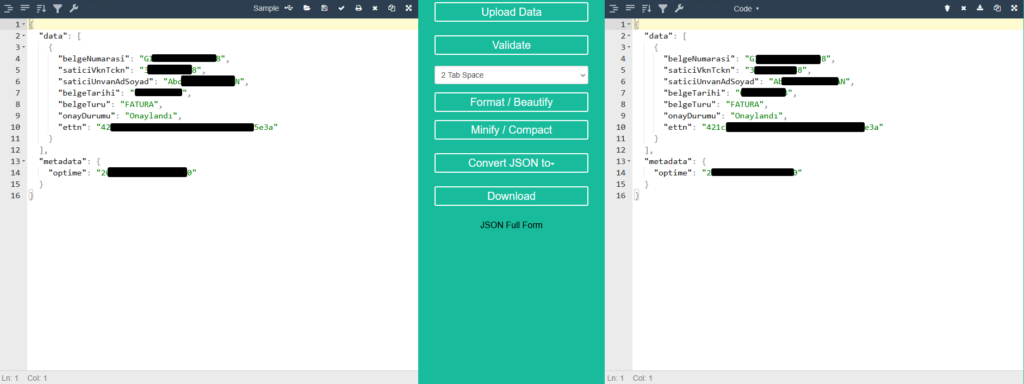
Belgede:
- Fatura numarası
- Vergi kimlik numarası
- Şirket bilgileri
- Fatura tarihi
- ETTN numarası
yer almaktadır. Bu veriler normal şartlarda yalnızca ilgili tarafların erişmesi gereken finansal kayıtlardır. Ancak formatter servisinde herkese açık olarak erişilebilir hale gelmiştir.
Vaka 6: Banka Müşterisinin Kredi Bilgileri
Araştırmacılar büyük bir Türk bankasına ait mobil uygulama çıktısını da tespit etmiştir.
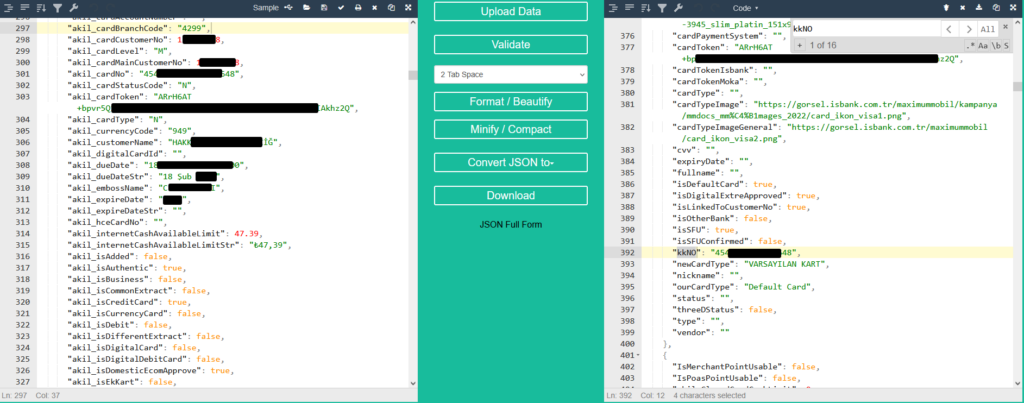
JSON içerisinde:
- Müşteri kredi limiti
- Kullanılabilir limit
- Toplam borç
- Kredi kartı bilgileri
yer almaktadır.
Belgede müşterinin:
- 10.000 TL kredi limiti
- Negatif bakiyesi
- Kullanılabilir limiti
açık şekilde görüntülenmektedir. Araştırma raporunda bankanın ismi özellikle belirtilmemiştir.
Vaka 7: Bir Şirketin Tüm Müşteri Veritabanı
Belki de Türkiye bölümündeki en dikkat çekici örneklerden biri budur. Bir hosting şirketine ait müşteri listesi tespit edilmiştir.
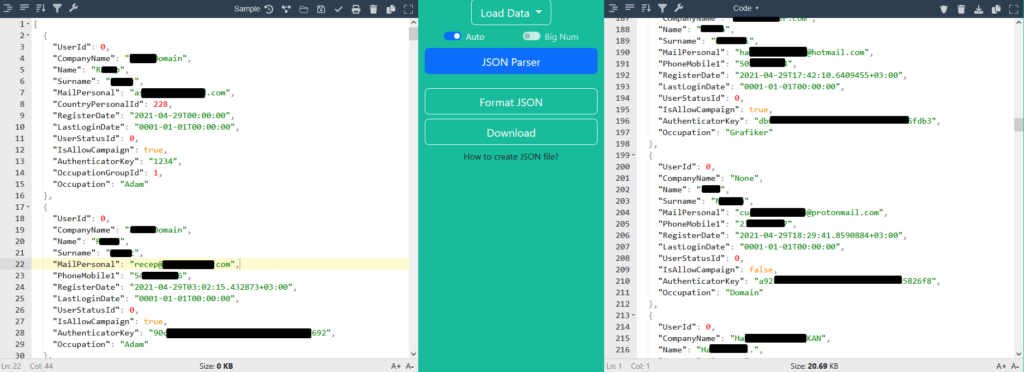
Toplam:
- 47 müşteri kaydı
aynı belge içerisinde yer almaktadır.
Her müşteri için:
- Ad Soyad
- E-posta adresi
- Telefon numarası
- Kayıt tarihi
bilgileri bulunmaktadır. Ancak en kritik bilgi iki faktörlü doğrulama anahtarlarıdır. Araştırmacılar her kullanıcı için:
- AuthenticatorKey
değerlerinin de bulunduğunu belirtmektedir. Bu durum yalnızca kişisel verilerin değil, hesap güvenliğinin de tehlikeye girmesi anlamına gelmektedir.
Türkiye İçin Sonuç
Araştırma ekibine göre Türkiye’nin diğer ülkelerden farklı olduğu nokta veri miktarı değildir. Asıl dikkat çekici nokta maruziyet biçimidir.
Araştırmacılar şu sonuca ulaşmıştır:
- Vatandaş kimlik bilgileri
- TCKN kayıtları
- Kredi kartları
- Sigorta poliçeleri
- Bankacılık verileri
- e-Fatura kayıtları
- Müşteri veritabanları
aynı küresel problem nedeniyle açığa çıkmıştır. Sorun Türkiye’ye özgü değildir. Ancak Türkiye’deki kurumlar da aynı riskten etkilenmektedir.
Neden Bu Bir KVKK Meselesidir?
Araştırmacılara göre konu yalnızca teknik bir güvenlik sorunu değildir. Asıl soru şudur: Kurum çalışanlarınız üretim verilerini üçüncü taraf bir web servisine yapıştırıyor mu?
Eğer cevap evet ise:
- Kişisel veri işleme gerçekleşmiştir.
- Veri üçüncü tarafa aktarılmıştır.
- Kurum kontrolü dışına çıkmıştır.
Araştırmacılar özellikle KVKK’nın 12. maddesi kapsamında bu konunun değerlendirilmesi gerektiğini belirtmektedir.
Araştırmaya göre birçok kurum:
- Verilerinin bu sistemlerde bulunduğunu bilmiyor.
- Çalışanlarının bu servisleri kullandığını bilmiyor.
- Veri aktarımının gerçekleştiğinin farkında değil.
LLM (Yapay Zeka) Çağı: Yeni Nesil Veri Sızıntıları
Araştırmanın en dikkat çekici bulgularından biri, 2024 sonrasında ortaya çıkan yeni bir veri türüdür. Bu veri türü doğrudan yapay zekâ destekli yazılım geliştirme süreçlerinden kaynaklanmaktadır. Araştırmacılara göre 2022 yılında bu tür içeriklere neredeyse hiç rastlanmazken, 2026 yılına gelindiğinde bunlar ayrı bir kategori oluşturacak seviyeye ulaşmıştır.
Sistem Promptları İnternete Sızıyor
Araştırma kapsamında:
- 487 belge orta veya yüksek güven seviyesinde sistem promptu olarak sınıflandırılmıştır.
- 131 belge ise çok yüksek doğrulukla sistem promptu olarak tespit edilmiştir.
Bu belgelerin önemli bir bölümü test amaçlı içerikler değildir.
İçlerinde:
- Gerçek müşteri bilgileri
- Şirket içi ürün isimleri
- Örnek kişisel veriler
- Gerçek iş süreçleri
yer almaktadır. Araştırmacılar örneklerden birinde şu senaryoyu açıklamaktadır: Bir kullanıcı bir yapay zekâ uygulamasına özet çıkartmak istemektedir.
Prompt hazırlığı sırasında:
- Aile mahkemesine ait bir tanık ifadesi
- Taraf bilgileri
- Çocuk bilgileri
yapay zekaya verilecek metin olarak formatter servisine yüklenmiştir. Yapay zekâ sistemi ile formatter arasında herhangi bir bağlantı bulunmamaktadır. Ancak kullanıcı hazırlık amacıyla metni formatter servisine kaydettiği için veri sızmıştır.
RAG (Retrieval-Augmented Generation) Verileri
Araştırmacılar 30 farklı belgede RAG sistemlerine ait çıktılar bulmuştur.
Bu belgelerde:
- chunk_id
- source
- metadata
- embedding verileri
yer almaktadır. RAG sistemlerinin temel amacı kurum içi bilgi kaynaklarından veri çekerek yapay zekâya sağlamaktır. Dolayısıyla bu tip kayıtların sızması şu anlama gelmektedir: Kurumun kendi bilgi tabanında bulunan veriler doğrudan kamuya açık hale gelmiştir. Araştırmacılar etik sebeplerle bu kurumların isimlerini açıklamamıştır.
Yapay Zekâya Hata Mesajı Gönderirken Sızan Veriler
31 farklı belge belirli bir ortak yapıya sahiptir.
Bu belgelerde:
- Hata mesajları
- Stack Trace kayıtları
- Authorization Header bilgileri
- İç sistem adresleri
- Uygulama logları
bulunmaktadır. Araştırmacılara göre geliştiriciler bu bilgileri ChatGPT benzeri sistemlere göndermeden önce formatter servisine yapıştırmış ve düzenlemiştir.
Amaç: Hata mesajını daha okunabilir hale getirip yapay zekâdan yardım almak. Sonuç: Veri internet üzerinde kalıcı hale gelmiştir.
Açığa Çıkan Yapay Zeka API Anahtarları
Araştırmada:
- 98 farklı LLM API anahtarı
- 72 Google AI anahtarı
- 23 farklı yapay zekâ servis sağlayıcısına ait anahtar
- 3 OpenAI anahtarı
tespit edilmiştir.
Bunlar arasında:
- OpenAI
- Google AI
- Cohere
- Mistral
- Groq
- Replicate
- Together
- OpenRouter
gibi servisler bulunmaktadır. Araştırmacıların dikkat çektiği örneklerden birinde yapay zekâ destekli bahis tahmini yapan bir uygulamanın kaynak kodu paylaşılmıştır.
Kod içerisinde:
- Telegram Bot Token
- Chat ID
- OpenAI API Key
aynı dosya içerisinde yer almaktadır.
2026’da Hala Neden Bu Kadar Çok Veri Sızıyor?
Araştırmacılar bunun birkaç temel nedeni olduğunu belirtmektedir.
1. Geliştiriciler Formatter’ı Üçüncü Taraf Servis Olarak Görmüyor
Birçok geliştirici: jsonformatter.org ve benzeri siteleri: “Kendi tarayıcım içerisinde çalışan küçük araçlar” olarak algılamaktadır.
Oysa gerçekte:
- Veri sunucuya gönderilmektedir.
- Veri kaydedilmektedir.
- URL oluşturulmaktadır.
- Herkese açık listelerde yayınlanmaktadır.
Bu yanlış algı sistematik bir problemdir.
2. Secret Scanning Sistemleri Bu Trafiği İzlemiyor
Kurumsal güvenlik araçları genellikle:
- Git Commit
- Pull Request
- Source Code Repository
üzerindeki sırları tespit eder.
Ancak:
- Formatter servisleri
- Paste servisleri
- Geçici web araçları
çoğu zaman izlenmez.
3. Yapay Zeka Kullanımı Bu Davranışı Artırdı
Araştırmacılar özellikle şu davranışın yaygınlaştığını belirtmektedir:
- Üretim verisini kopyala
- Formatter ile düzenle
- Yapay zekâya gönder
- Hata çözümünü al
Bu süreçte veriler istemeden internete sızmaktadır.
4. Servis İşletmecisinin Teşviki Bulunmuyor
Araştırmaya göre servis işletmecisinin mevcut çalışma modelinde:
- Verileri silme zorunluluğu bulunmuyor.
- Herkese açık listeyi kapatma zorunluluğu bulunmuyor.
- Kullanıcının yüklediği veriler kendi isteğiyle yüklenmiş kabul ediliyor.
Dolayısıyla problem kendi kendine çözülecek bir problem değildir.
Stored XSS Açığı
Araştırmanın en kritik teknik bulgularından biri platformda bulunan Stored XSS açığıdır. Araştırmacılar başlangıçta yalnızca veri sızıntılarını incelemektedir. Ancak analiz sırasında ikinci bir problem keşfetmişlerdir.
Açığın Temeli
Sistem kaydedilen içerikleri görüntülerken kullanıcı girdisini yeterince filtrelememektedir.
Bu nedenle saldırgan:
- Zararlı içerik oluşturabilir.
- İçeriği kaydedebilir.
- URL’yi paylaşabilir.
Sonuç olarak saldırganın JavaScript kodu ziyaretçinin tarayıcısında çalıştırılabilir.
Kullanılan Örnek Payload
Araştırmacılar aşağıdaki örnek payload ile açığı doğrulamıştır:
"><svg onload=alert(self['docu'+'ment']['domain'])>Bu payload:
- Script etiketi kullanmamaktadır.
- Yasaklanan kelimeleri doğrudan içermemektedir.
- Çalıştırıldığında ilgili alan adını göstermektedir.
Amaç yalnızca açığın varlığını kanıtlamaktır.
Bu Açık Neden Daha Tehlikeli?
Araştırmacılara göre normal bir web sitesindeki XSS ile bu platformdaki XSS aynı değildir.
Çünkü aynı platformda zaten:
- API anahtarları
- JWT tokenları
- Kredi kartları
- Kimlik numaraları
- Kurumsal veriler
bulunmaktadır.
Bu nedenle saldırgan:
- Kullanıcının görüntülediği verileri okuyabilir.
- Oturum bilgilerini kullanabilir.
- İçeriği değiştirebilir.
- Yeni saldırılar başlatabilir.
- Kimlik avı saldırıları gerçekleştirebilir.
Güvenlik Açığının Bildirilmesi
Araştırmacılar Stored XSS açığını: 3 Haziran 2026 tarihinde servis işletmecisine bildirdiklerini açıklamıştır.
Önerilen düzeltmeler:
- HTML Output Encoding uygulanması
- textContent kullanılması
- Content Security Policy (CSP) eklenmesi
- Blacklist yaklaşımının kaldırılması
şeklindedir.
Bu Araştırma Neden Yayınlandı?
Araştırmacılar şu noktaya özellikle vurgu yapmaktadır:
- Herhangi bir canlı anahtar yayınlanmadı.
- Herhangi bir parola yayınlanmadı.
- Herhangi bir gerçek veri paylaşılmadı.
- Tüm örnekler maskeleştirildi.
Amaç:
- Kurumları uyarmak
- Düzenleyici kurumları bilgilendirmek
- Farkındalık oluşturmak
olarak açıklanmaktadır.
Kurumlar Ne Yapmalı?
Araştırmacılar altı temel öneri sunmaktadır.
1. Geliştirici Bilgisayarlarından Bu Servislere Erişimi Engelleyin
Proxy ve web filtreleri üzerinden:
- JSON Formatter
- Paste servisleri
- Benzeri araçlar
engellenmelidir.
2. Yerel Araçlar Kullanın
Modern IDE’ler zaten:
- JSON formatlama
- XML formatlama
- Kod biçimlendirme
özelliklerini desteklemektedir. İnternet üzerindeki servislere ihtiyaç yoktur.
3. Yapay Zeka İş Akışlarını Kontrol Altına Alın
Yapay zekâya gönderilen verilerin:
- Kurumsal veri içerip içermediği
- Üretim sistemlerinden gelip gelmediği
denetlenmelidir.
4. Düzenleyici Kurumlar Konuyu Veri İşleme Faaliyeti Olarak Değerlendirmeli
Araştırmacılara göre: KVKK, GDPR ve benzeri düzenlemeler kapsamında, üçüncü taraf formatter servislerine veri gönderilmesi bir veri işleme faaliyetidir.
5. USOM ve Benzeri Yapılar Bu Kaynakları Sürekli İzlemeli
Kamuya açık veri paylaşım servisleri:
- IOC üretimi
- Tehdit istihbaratı
- Veri sızıntısı tespiti
için düzenli olarak takip edilmelidir.
6. Stored XSS Açığı Gidermeli
Araştırmacılara göre: Herkese açık liste tasarım tercihi olabilir. Ancak Stored XSS bir tasarım tercihi değil, güvenlik açığıdır. Mutlaka düzeltilmelidir.
Araştırmanın ulaştığı temel sonuç oldukça nettir: Bu veri havuzu hâlen erişilebilirdir. Veriler halen herkese açıktır. En az bir üçüncü tarafın bu verileri düzenli olarak topladığı daha önce kanıtlanmıştır.
Türkiye özelinde ortaya çıkan sonuç ise şudur:
- Vatandaşlara ait TCKN’ler
- Banka kayıtları
- Kredi kartları
- Sigorta poliçeleri
- e-Fatura kayıtları
- Müşteri veritabanları
aynı küresel problem nedeniyle açığa çıkmıştır. Araştırmacılar raporu şu ifadeyle sonlandırmaktadır. Sorulması gereken soru, bu maruziyetin var olup olmadığı değildir. Araştırma bunu zaten kanıtlamıştır. Asıl soru, kurumların ve düzenleyici otoritelerin buna bugün mü müdahale edeceği, yoksa altı ay sonra kendi verileri ortaya çıktığında mı harekete geçeceğidir.
Kaynak: https://beyondmemory.io/blog/json-formatter-data-exposure



Eline sağlık.