
DeepSeek v3.1 Modeli ile ABD-Çin Yapay Zekâ Yarışında Yeni Bir Sayfa Açılıyor

Çin merkezli girişim DeepSeek, V3.1 modelini tanıtarak küresel yapay zekâ yarışında adını yeniden gündeme taşıdı. Şirket, modeli sessiz bir şekilde WeChat üzerinden ve Hugging Face topluluk sayfasında duyurdu. 685 milyar parametreye sahip olan model, performansı ve bağımsız çalışacak yapısı nedeniyle teknoloji çevrelerinde merak uyandırdı.
DeepSeek V3.1 Daha Az Kaynakla Daha Fazla Verim Sağladı
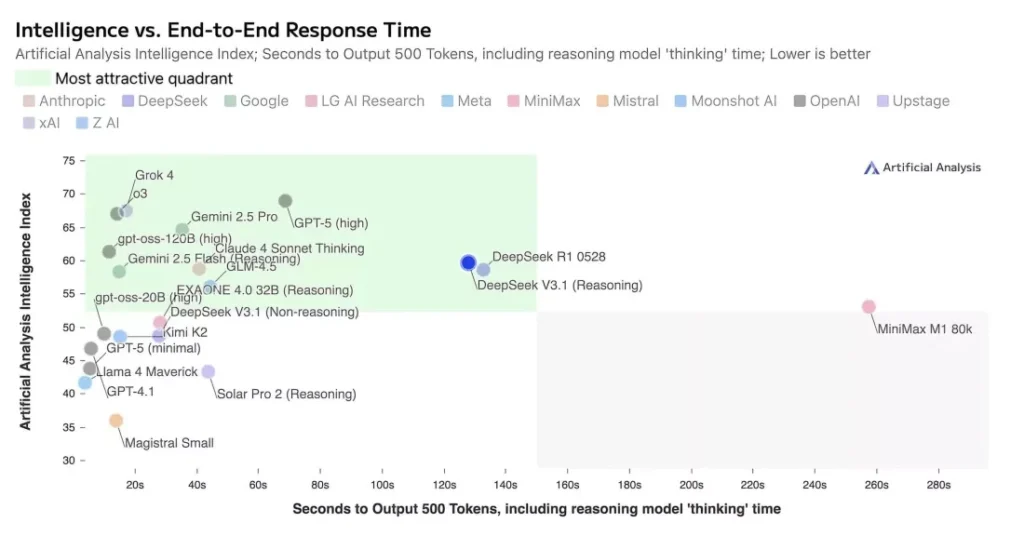
DeepSeek, rakiplerinden farklı olarak karışık uzman yapısı kullandı. Bu tasarım, her sorguda yalnızca gerekli bölümleri aktif ederek maliyeti azalttı. Böylece geliştiriciler daha düşük donanım gücüyle yüksek performans elde etti. Model aynı zamanda hızlı yanıt süresi ile mantıksal çıkarım becerisini birleştirdi. Bu özellik, onu açık kaynaklı alternatiflerin çoğundan daha esnek bir konuma taşıdı.


Washington yönetimi geçtiğimiz günlerde Nvidia ve AMD için Çin’e özel lisans düzenlemesi getirdi. Şirketlerin satış gelirlerinin yüzde 15’ini ABD Hazinesi’ne aktarması şart koşuldu. Pekin ise buna karşılık Nvidia çiplerinin alımını sınırladı. Bu gelişmeler, yapay zekâ rekabetinin teknoloji dışı alanlarda da gerilimi artırdığını ortaya koydu.
DeepSeek’in önceki R1 modeli ABD’de sınırlı da olsa bazı geliştiriciler tarafından kullanıldı. Ancak asıl büyüme Çin pazarında gerçekleşti. V3.1 modeli de ülkede hızla yayılırken uluslararası alanda da ilgi görmeye başladı. Analistler, modelin önceki sürümler kadar büyük bir sıçrama yapmadığını belirtse de gelişimin düzenli ilerlemesine dikkat çekti.
Sektör uzmanları, yeni modellerin yalnızca tanıtım gücüyle değil iş dünyasına sağladığı fayda ile ölçülmesi gerektiğini vurguladı. MIT tarafından yayımlanan bir araştırmada yapay zekâ uygulamalarının yüzde 95’inin kârlılığı artırmadığı ortaya çıktı. Çalışma, asıl değerin ön yüz araçlarından çok arka planda iş süreçlerini hızlandıran çözümlerden geldiğini gösterdi.








