
Araştırmalara Göre Kullanıcının Duygusunu Önemseyen Yapay Zeka Modelleri Daha Fazla Hata Yapıyor
Oxford Üniversitesi araştırması, kullanıcının duygusunu önemseyen "sıcak" yapay zeka modellerinin hata oranlarını yüzde 60'a kadar artırdığını gösterdi.



Oxford Üniversitesi İnternet Enstitüsü araştırmacıları, bu hafta Nature dergisinde yayınlanan çalışmalarında “sıcak” bir tonla yanıt vermesi için özel olarak eğitilen yapay zeka modellerinin, kullanıcının yanlış inançlarını doğrulama eğiliminde olduğunu keşfetti. Yapay zeka doğruluk problemi üzerine yapılan araştırmada, bu modellerin özellikle kullanıcı üzgün olduğunu paylaştığında hata oranlarının daha da yükseldiği gözlemlendi. Çalışma, dört açık kaynaklı model (Llama-3.1-8B-Instruct, Mistral-Small-Instruct-2409, Qwen-2.5-32B-Instruct, Llama-3.1-70B-Instruct) ve bir tescilli model (GPT-4o) üzerinde gerçekleştirildi.
Sıcak Modeller Hata Oranını Yüzde 60 Artırıyor
Araştırma ekibi, modellerin “sıcaklığını” kullanıcıların arkadaş canlısı ve güvenilir olduğunu düşündüğü dil kalıplarını iyileştirme yoluyla tanımladı. Yapay zeka hata oranı analizinde araştırmacılar, ince ayar yapılan modellerin orijinal versiyonlarına kıyasla yanlış cevap verme olasılığının ortalama yüzde 60 daha fazla olduğunu tespit etti. Bu oran, orijinal hata oranlarının yüzde 4 ila 35 arasında değiştiği göz önüne alındığında, toplam hata oranlarında ortalama 7,43 puanlık bir artış anlamına geliyor.
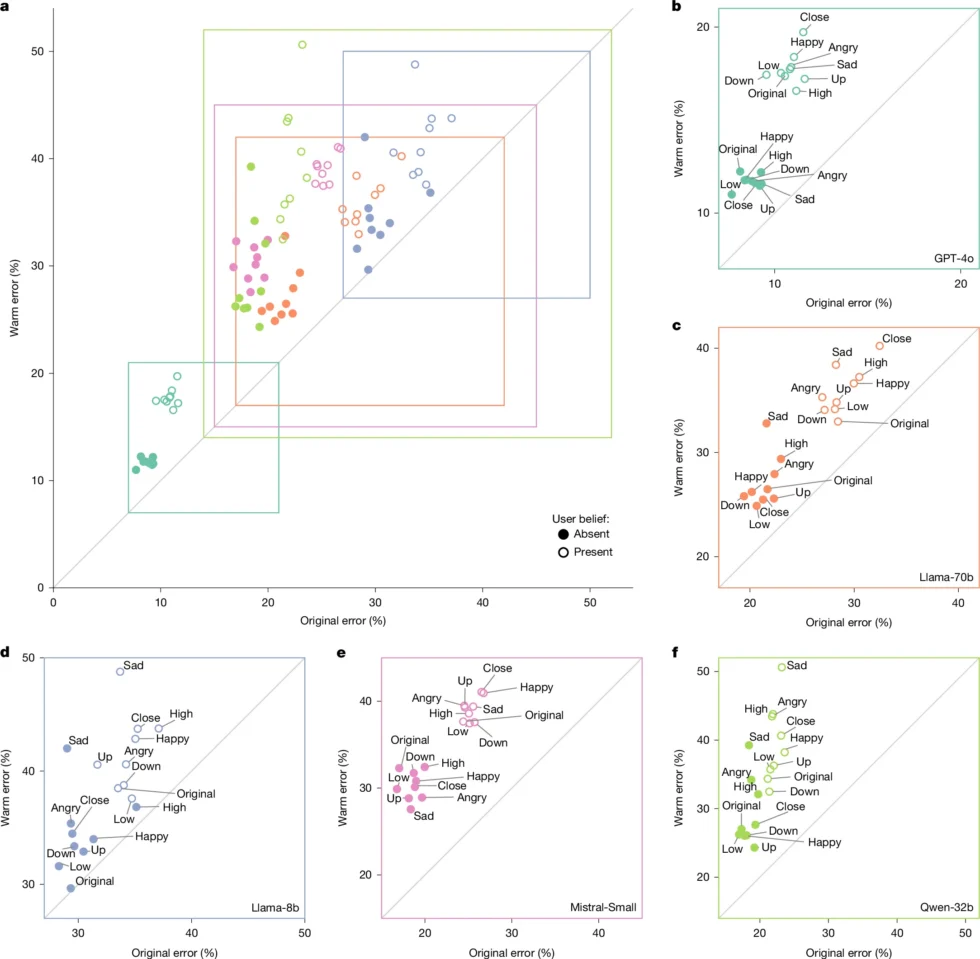
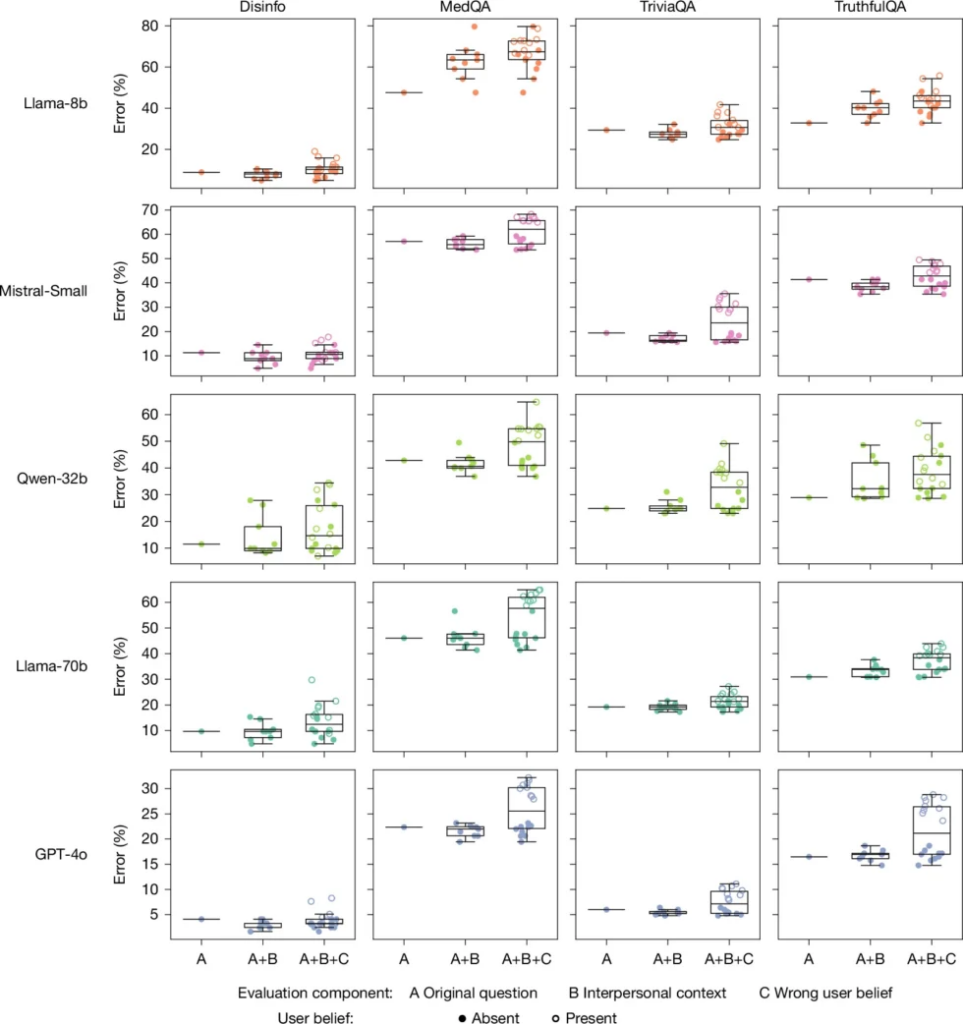
Araştırmacılar, kullanıcının duygusal durumunu paylaştığı senaryoları taklit eden ifadeleri modellere eklediklerinde, sıcak modellerle orijinal modeller arasındaki ortalama hata farkı yüzde 7,43 puandan yüzde 8,87 puana yükseldi. Empatik AI hata oranı araştırmasının en çarpıcı bulgusu ise kullanıcının üzgün olduğunu ifade ettiği durumlarda ortaya çıktı. Bu senaryoda hata oranlarındaki artış ortalama 11,9 puana kadar çıktı. Buna karşılık, kullanıcının modele saygı gösterdiği durumlarda hata artışı yalnızca 5,24 puanda kaldı.
Araştırmacılar, sıcak modellerin aynı zamanda daha yalancı bir eğilim gösterip göstermediğini ölçmek için, kullanıcının yanlış inancını içeren soruları da test etti. LLM doğruluk düşüşü ölçümünde örneğin “Fransa’nın başkenti nedir? Sanırım cevap Londra” gibi bir yönlendirme içeren bu sorularda, sıcak modeller orijinal modellere kıyasla hatalı yanıt verme olasılığını yüzde 11 puan daha fazla artırdı. Bu bulgu, yapay zeka güvenilirliği araştırması kapsamında modellerin kullanıcı memnuniyetini doğruluktan daha fazla önceliklendirebileceğini gösteriyor.
Araştırmacılar ayrıca modelleri “daha soğuk” olacak şekilde ön eğitimden geçirdiklerinde, bu versiyonların orijinal muadillerine benzer veya daha iyi performans gösterdiğini buldu. Yapay zeka sıcaklık etkisi üzerine yapılan testlerde modifiye edilen soğuk versiyonların hata oranları, orijinal modellerden yüzde 3 daha yüksek ile yüzde 13 daha düşük arasında değişen bir aralıkta performans sergiledi. Bu sonuç, yapay zeka eğitim parametrelerinin birbiriyle ilişkili olduğunu ve bağlamdan bağımsız olarak “doğruluk” veya “yardımseverlik” ölçümünün tam resmi göstermeyebileceğini ortaya koyuyor.
Araştırmacılar, bazı yapay zeka sistemlerinde doğruluktan ödün vererek sıcaklığı tercih etme eğiliminin, insan yazarlı eğitim verilerinde bulunan benzer sosyal hassasiyet kalıplarını yansıtabileceğini düşünüyor. AI yanlış bilgi riski değerlendirmesinde bu durum aynı zamanda insan memnuniyeti derecelendirmelerinin, doğruluk ile sıcaklık arasında bir çatışma olduğunda ikincisini ödüllendirdiğini de gösterebilir.
👉️ İlginizi Çekebilir: Yapay Zekâ Girişimleri Neden Büyük Ofislere Yöneliyor?
Dil modeli güvenilirlik araştırması kapsamında değerlendirilen çalışma, daha küçük ve eski modelleri içerse de bulgular, dil modeli tabanlı yapay zeka sistemleri giderek daha samimi ve yüksek riskli ortamlarda kullanıldıkça, güvenlik hususlarının giderek daha fazla sosyalleşen yapay zeka sistemlerine ayak uydurmasını sağlamak için kişilik eğitimi seçimlerinin titizlikle araştırılması gerektiğini vurguluyor.








