Nvidia, farklı donanımlarda çalışabilen ve yapay zekâ ajanlarına odaklanan üç yeni açık ağırlıklı modelini duyurdu. Nemotron 3.5 Super VL, Nemotron 3.5 Bolt 74B-A9B 24GB ve Nemotron 3.5 Bolt E4B 4GB adlarını taşıyan modeller, yüksek işlem kapasitesinden sınırlı belleğe sahip sistemlere kadar farklı kullanım senaryolarını hedefliyor. Şirket, ilk iki modeli kullanıma sunarken daha küçük sohbet odaklı Bolt E4B 4GB sürümünün yayın tarihini 23 Ekim olarak açıkladı.
Nemotron 3.5 Super VL, Gelişmiş Yapay Zekâ Ajanlarına Odaklanıyor
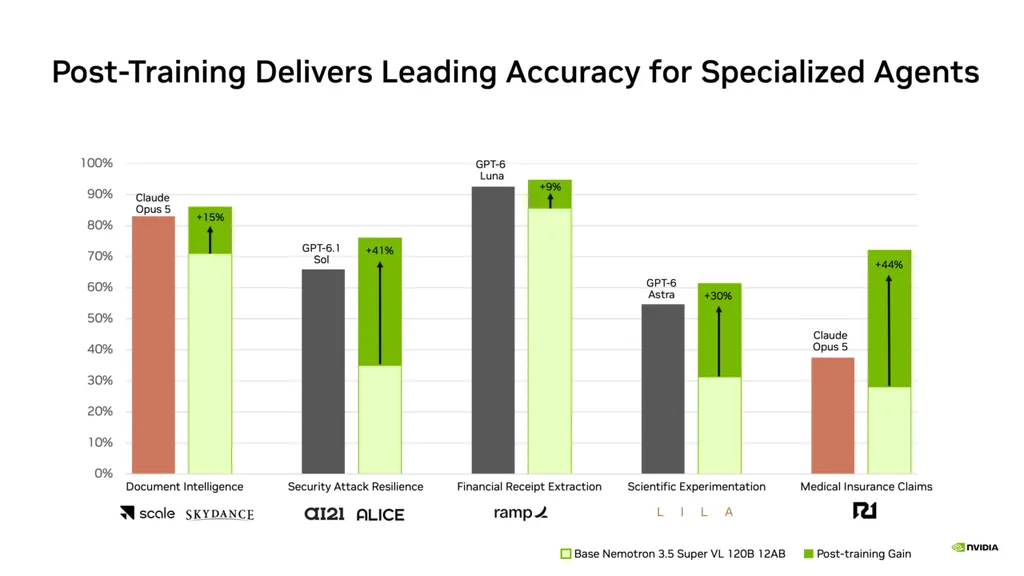
Nvidia’nın yeni model ailesindeki Nemotron 3.5 Super VL, 120 milyar parametreyle serinin yüksek kapasiteli seçenekleri arasında yer alıyor. Şirket, modeli özellikle birden fazla aşamadan oluşan görevleri yürüten yapay zekâ ajanları için geliştirdiğini belirtiyor. Nvidia’nın açıklamasına göre Super VL, bazı görevleri Opus 5, GPT 6.1 Sol, Luna ve Astra gibi üst düzey modellerden daha hızlı tamamlayabiliyor.
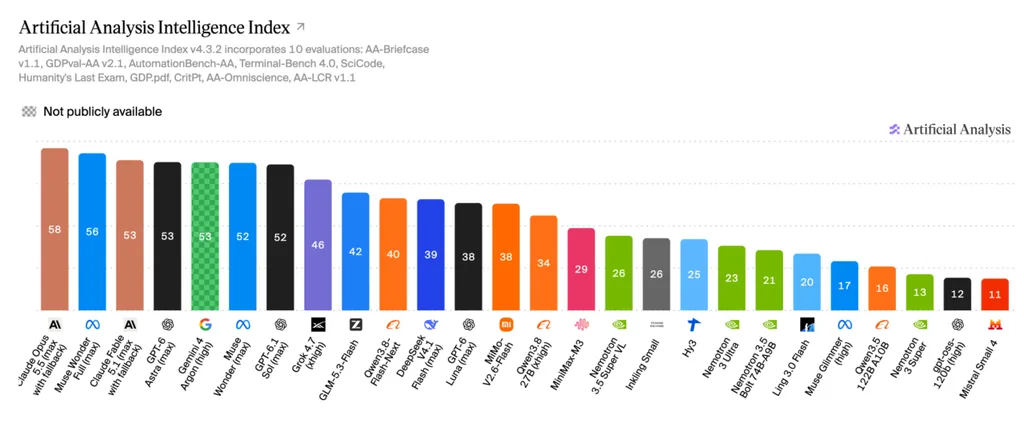

Modelin performans iddiaları, belirli görevlerde işlem süresini azaltmaya yönelik yaklaşımı öne çıkarıyor. Bununla birlikte hız karşılaştırmalarının hangi test koşullarında ve hangi görevler üzerinde yapıldığı, performans değerlendirmesinde belirleyici olacak unsurlar arasında bulunuyor.
Nemotron 3.5 Super VL, yalnızca bulut altyapısıyla sınırlı kalmayarak desteklenen yerel sistemlerde de çalıştırılabiliyor. Nvidia, modelin DGX Spark, DGX Station, RTX PRO ve uyumlu RTX ekran kartlarına sahip bilgisayarlarda kullanılabildiğini bildiriyor. Yerel çalıştırma seçeneği, kurumların ve geliştiricilerin uygun donanımla kendi sistemleri üzerinde yapay zekâ uygulamaları geliştirmesine imkân tanıyor.
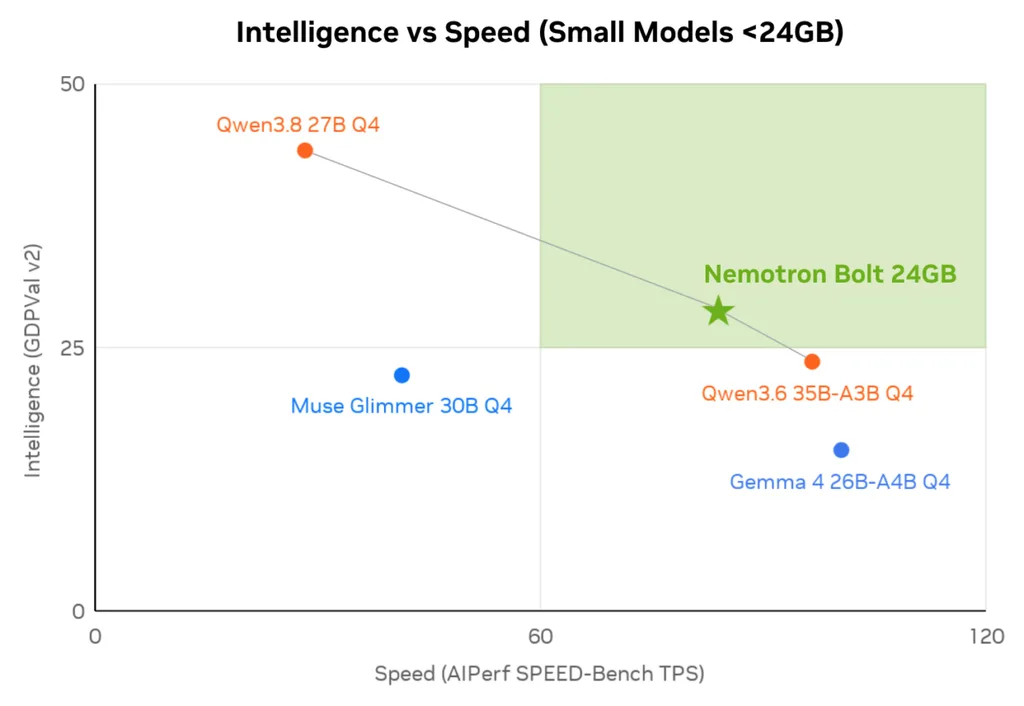
Nvidia’nın ikinci modeli Nemotron 3.5 Bolt 74B-A9B 24GB, daha sınırlı donanım kaynaklarıyla yapay zekâ ajanlarını çalıştırmayı hedefliyor. RTX ve DGX Spark sistemlerine yönelik geliştirilen model, yerleşik 2 bit kuantizasyon teknolojisi sayesinde 24 GB belleğe sığacak şekilde tasarlanmış durumda.
Kuantizasyon, model ağırlıklarının daha az bellek kullanacak biçimde temsil edilmesini sağlayan teknikler arasında yer alıyor. Nvidia’nın yaklaşımı, daha büyük model ailelerinin bazı yeteneklerini daha erişilebilir donanımlara taşımayı amaçlıyor. Şirket, Bolt 74B-A9B modelinin gündelik ajan görevlerini diğer uygulamalarla eş zamanlı olarak yürütebildiğini belirtiyor.
Bu tasarım, aynı bilgisayarda birden fazla uygulama kullanan geliştiriciler açısından önem taşıyor. Bellek kullanımının sınırlandırılması, uygun donanımlarda yerel yapay zekâ iş akışlarına ayrılabilecek kaynakları artırabilir. Gerçek performans ise kullanılan ekran kartına, diğer uygulamaların kaynak tüketimine ve çalıştırılan görevin niteliğine göre değişebilir.
Nemotron 3.5 Bolt E4B 4GB, yeni ailede daha küçük bellek gereksinimine sahip seçenek olarak konumlanıyor. Nvidia, modeli GeForce RTX, Jetson ve RTX/DGX Spark platformları için geliştiriyor. Dört gigabaytlık bellek hedefiyle hazırlanan model, özellikle sohbet tabanlı ajanlar ve gömülü yapay zekâ arayüzleri için tasarlanıyor.
Şirketin belirttiği kullanım alanları arasında yüksek hızlı sesli asistanlar, etkileşimli karakterler ve gömülü arayüzler bulunuyor. Bu senaryolar, kullanıcı girdilerine hızlı yanıt verilmesini ve yapay zekâ özelliklerinin daha geniş bir uygulama yelpazesine entegre edilmesini gerektiriyor.
Daha küçük model boyutu, kaynakları sınırlı sistemlerde dağıtım seçeneklerini genişletebilir. Bununla birlikte modelin belirli cihazlardaki yanıt süresi ve doğruluğu, donanım yapılandırmasıyla birlikte uygulamanın gereksinimlerine bağlı olacak.
Nemotron 3.5 ailesi, yüksek kapasiteli ajan görevlerinden düşük bellek gerektiren sohbet uygulamalarına kadar farklı ihtiyaçlara yanıt vermeyi amaçlıyor. Super VL, gelişmiş işlem kapasitesi gerektiren iş akışlarına odaklanırken Bolt 74B-A9B bellek verimliliğini, Bolt E4B ise daha küçük sistemlerde kullanılabilecek sohbet deneyimlerini öne çıkarıyor.
Nvidia, Nemotron 3.5 Super VL ile Nemotron 3.5 Bolt 74B-A9B 24GB modellerini duyuruyla birlikte kullanıma sundu. Nemotron 3.5 Bolt E4B 4GB için açıklanan tarih ise 23 Ekim 2026 olarak belirtildi. Üçüncü modelin yayınlanmasıyla birlikte geliştiriciler, uyumlu donanımlar ve uygulama gereksinimleri doğrultusunda daha küçük ölçekli ajan çözümlerini değerlendirebilecek.