Inception, GPT-6 Luna’dan 8 Kat Daha Hızlı Olduğunu İddia Ettiği Mercury 3’ü Tanıttı

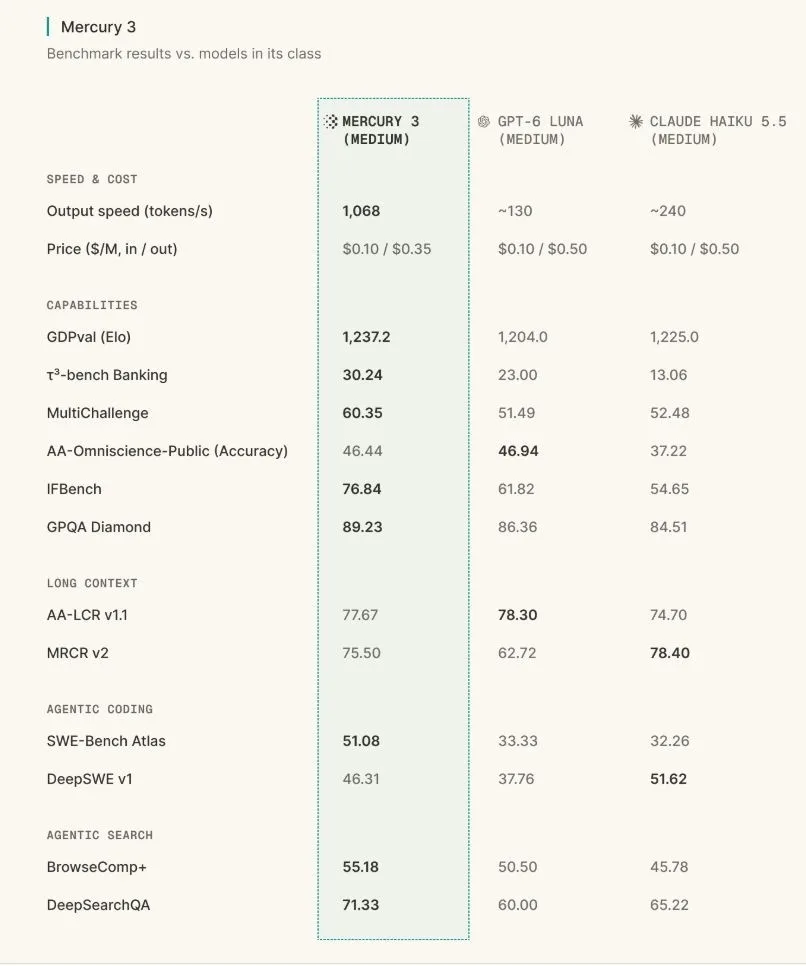
Inception, yeni yapay zekâ modeli Mercury 3’ün bazı performans testlerinde GPT-6 Luna ve Claude Haiku 5.5 gibi rakiplerini geride bıraktığını, üretim hızında ise 8 kata kadar avantaj sağladığını öne sürdü. NVIDIA ekran kartlarında saniyede 1.000’den fazla token üretebildiği belirtilen model, 1 milyon tokenlık bağlam penceresiyle de uzun metinleri işleme kapasitesini artırmayı hedefliyor. Diffusion tabanlı dil modeli yaklaşımını kullanan Mercury 3, özellikle hızlı yanıt gerektiren yazılım geliştirme araçları, yazma asistanları ve etkileşimli uygulamalarda yeni kullanım alanları oluşturmayı amaçlıyor.
Mercury 3, Diffusion Tabanlı Metin Üretiminde Hızı Artırmayı Hedefliyor
ABD merkezli Inception, Mercury 3 ile geleneksel dil modellerinden farklı bir metin üretim yaklaşımını daha büyük ölçeğe taşımayı hedefliyor. Geleneksel büyük dil modelleri, yanıtlarını çoğunlukla token adı verilen metin parçalarını sırayla üreterek oluştururken diffusion tabanlı modeller metnin farklı bölümlerini paralel biçimde işleyip aşamalı olarak iyileştirebiliyor.

Bu yaklaşım, özellikle uzun yanıtların hazırlanmasında işlem süresini azaltma potansiyeli taşıyor. Ancak gerçek hız kazancı, modelin mimarisine, kullanılan donanıma, görev türüne ve ölçüm yöntemine bağlı olarak değişebiliyor. Inception, Mercury 3’ün rakiplerine kıyasla 4 ila 8 kat daha hızlı çalışabildiğini savunurken bu sonuçların bağımsız testlerle doğrulanması gerekiyor.
Şirketin açıklamasına göre Mercury 3, önceki Mercury 1 modelinden 40 kattan fazla büyük olmasına rağmen saniyede 1.000 tokenın üzerinde üretim hızını koruyabiliyor. Söz konusu performans iddiası, diffusion tabanlı yapay zekâ modellerinin ölçek büyüdükçe hız avantajını koruyup koruyamayacağı açısından önem taşıyor.
Inception’ın yeni modeli, uzun belgeler ve geniş veri kümeleri üzerinde çalışmak isteyen kullanıcılar için 1 milyon tokenlık bağlam penceresi sunuyor. Şirketin önceki modeli Mercury 2.5, 260 bin tokenlık bağlam kapasitesiyle sınırlıyken yeni sürüm bu değeri önemli ölçüde artırıyor.
Bağlam penceresi, bir yapay zekâ modelinin tek bir işlem sırasında dikkate alabildiği metin ve diğer içerik miktarını ifade ediyor. Daha geniş bir pencere, modelin uzun belgeler, kapsamlı kod tabanları veya birden fazla doküman arasındaki ilişkileri aynı oturumda değerlendirmesine yardımcı olabiliyor. Bununla birlikte yüksek bağlam kapasitesi, tek başına her görevde daha doğru sonuç alınacağını garanti etmiyor.
Mercury 3’ün uzun bağlam desteği ile yüksek üretim hızını bir araya getirmesi, büyük miktarda bilgi üzerinde hızlı işlem yapılmasını gerektiren iş akışları açısından önem taşıyor. Geliştiriciler, uzun kod dosyalarını analiz ederken veya büyük doküman kümeleriyle çalışırken modelin hızını ve bağlam kapasitesini birlikte değerlendirebilecek.
Inception, Mercury 3’ü yanıt gecikmesinin kullanıcı deneyimini doğrudan etkilediği uygulamalarda kullanıma sunmayı amaçlıyor. Şirketin hedeflediği alanlar arasında etkileşimli eğitim sistemleri, canlı çeviri araçları, yazma asistanları ve otomatik yazılım ajanları bulunuyor.
Yüksek token üretim hızı, özellikle kullanıcıların modelden art arda yanıt beklediği uygulamalarda daha akıcı bir deneyim sağlayabilir. Yazılım ajanları açısından hızlı yanıt üretimi, kod önerilerinin hazırlanması ve çok aşamalı görevlerin yürütülmesi sırasında bekleme sürelerini azaltma potansiyeli taşıyor. Canlı çeviri ve eğitim uygulamaları da kısa yanıt sürelerinden yararlanabilecek alanlar arasında yer alıyor.
Şirket, Mercury 3’ün bazı müşteriler tarafından gerçek iş akışlarında test edildiğini belirtiyor. Ancak Inception, söz konusu iş birliklerinin kapsamı, bağımsız değerlendirme sonuçları veya modelin farklı donanımlardaki performansı hakkında ayrıntılı karşılaştırma verileri paylaşmıyor.
Mercury 3’ün GPT-6 Luna ve Claude Haiku 5.5 karşısında öne sürülen performansı, yapay zekâ modelleri arasındaki rekabette hızın önemini yeniden gündeme getiriyor. Bununla birlikte modellerin karşılaştırılabilmesi için aynı donanım, benzer görevler ve eşdeğer ölçüm koşulları kullanılarak test edilmesi gerekiyor. Token üretim hızı tek başına modelin akıl yürütme kalitesini, doğruluğunu veya genel yeteneklerini göstermiyor.
NVIDIA ekran kartlarında saniyede 1.000’den fazla token üretme iddiası da kullanılan GPU modeli, eşzamanlı kullanıcı sayısı ve yanıt uzunluğu gibi teknik ayrıntılarla birlikte değerlendirilmesi gereken bir ölçüt olarak öne çıkıyor. Bağımsız testler, Mercury 3’ün farklı görevlerde hız avantajını ne ölçüde koruduğunu ve bu avantajın çıktı kalitesine nasıl yansıdığını ortaya koyabilecek.
Inception’ın yaklaşımı, yapay zekâ alanında yalnızca daha büyük modeller geliştirmek yerine metin üretim yöntemlerini değiştirerek gecikmeyi azaltma arayışını temsil ediyor. Mercury 3’ün gerçek kullanım performansı doğrulandığı takdirde model, hızlı yanıt gerektiren uygulamalarda rekabetçi bir seçenek haline gelebilir.