Nvidia ile Cerebras’ın Yapay Zekâ Çiplerinde Rekor Hızlar Neden Gerçek Kullanımı Yansıtmıyor?

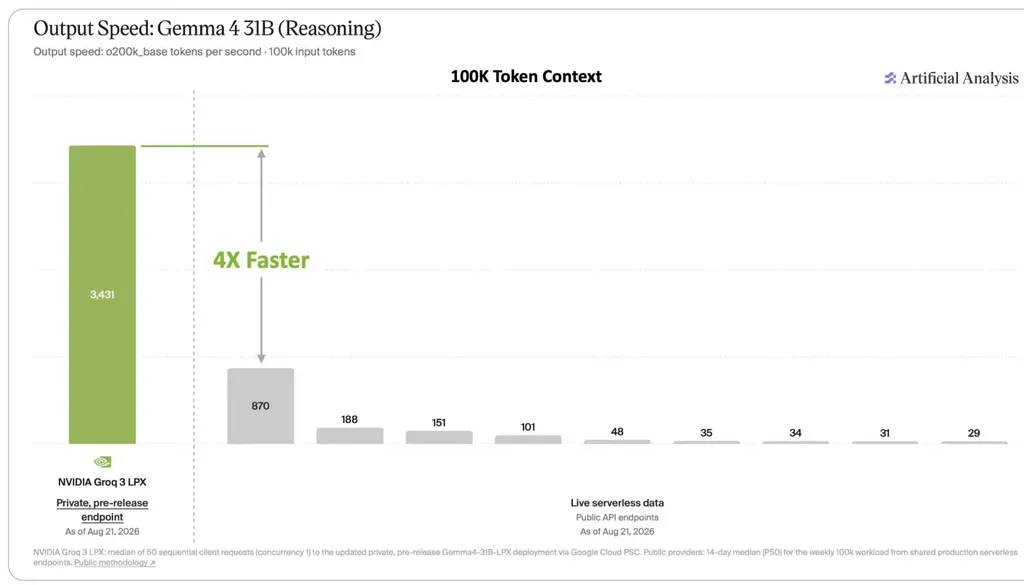
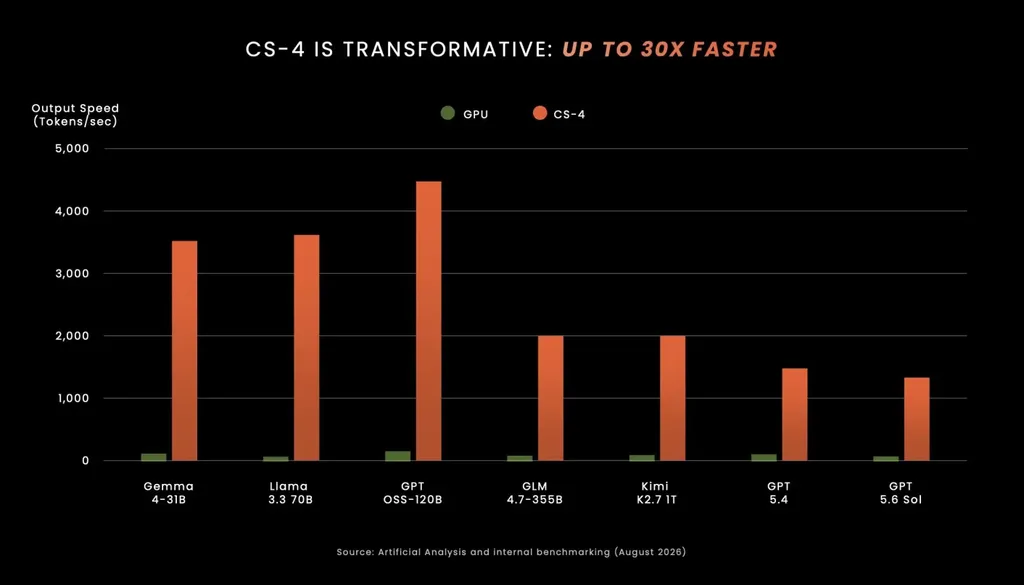
Nvidia ile Cerebras’ın yeni yapay zekâ hızlandırıcıları, tek kullanıcıya yönelik testlerde saniyede binlerce token üretim hızına ulaşarak dikkat çekti ancak bu sonuçlar gerçek üretim ortamlarında müşterilerin göreceği performansı doğrudan göstermiyor. Nvidia’nın Groq-3 tabanlı LPX sistemleri Gemma 4 31B modeliyle saniyede 3.400 token seviyesine ulaşırken Cerebras’ın yeni CS-4 sistemi benzer bir performans ortaya koydu. Asıl farkı belirleyecek ölçüt ise en yüksek token hızından çok aynı donanımın kaç kullanıcıya hangi maliyet, güç tüketimi ve gecikme düzeyiyle hizmet verebildiği olacak.
Tek Kullanıcı Testleri Gerçek Sistem Yükünü Yansıtmıyor
Hot Chips konferansında açıklanan sonuçlar, yapay zekâ çıkarımı alanında donanım üreticilerinin neden tek bir performans rakamına odaklandığını da gösteriyor. Artificial Analysis tarafından yapılan testlerde Nvidia’nın Groq-3 tabanlı LPX rafları Gemma 4 31B modelinde saniyede 3.400 token üretirken Cerebras’ın CS-4 hızlandırıcıları da benzer seviyeye yaklaştı. Tek bir isteğin mümkün olan en yüksek hızda işlenmesi açısından ortaya çıkan tablo etkileyici olsa da gerçek bir yapay zekâ hizmeti aynı anda çok sayıda kullanıcı, farklı uzunluklarda istemler ve değişken çıktı süreleriyle çalışıyor.

Bir yapay zekâ servis sağlayıcısı için performans hesabı yalnızca token üretim hızına bakılarak yapılamıyor. Nvidia GPU’ları, Groq LPUs veya Cerebras WSE tabanlı sistemler farklı bellek mimarileri kullandığı için aynı model farklı yük profillerinde farklı sonuçlar üretebiliyor. Özellikle yüksek etkileşim gerektiren sohbet uygulamalarında gecikme ile eşzamanlı kullanıcı sayısı birlikte değerlendirildiğinde tek kullanıcı testinin sunduğu rakamın ticari değeri azalıyor.
Gemma 4 31B gibi 31 milyar parametreli bir model, 8 bit hassasiyetle çalıştırıldığında yalnızca model ağırlıklarının tutulması için yaklaşık 31 GB belleğe ihtiyaç duyuyor. Groq-3 hızlandırıcılarının her birinde 500 MB çip üzeri bellek bulunması nedeniyle Nvidia’nın 3.400 tokenlik testinde model ağırlıklarını barındırmak için çok sayıda LPU’nun birlikte kullanılması gerekiyor. Uzun istemler sisteme eklendiğinde hesaplama yüküne ek olarak KV önbelleği de bellek tüketimini ciddi biçimde artırıyor.
100.000 token uzunluğundaki bir giriş, 8 bit hassasiyette yaklaşık 8 GB ek KV önbelleği oluşturabiliyor. Her kullanıcı kendi bağlamını oluşturduğu için uzun konuşmaların bulunduğu uygulamalarda bellek ihtiyacı kullanıcı sayısıyla birlikte büyüyor. 256 LPU içeren bir LPX rafı için yapılan hesaplama, 100.000 token giriş uzunluğu varsayımında yaklaşık 12 istemlik bir toplu işlem sınırına işaret ediyor; söz konusu değer doğrudan kullanıcı kapasitesi olarak değerlendirilmemeli çünkü gerçek sohbet trafiğinde istem uzunlukları, eşzamanlılık modeli ve ön işleme yöntemleri farklı sonuçlar ortaya çıkarıyor.
Cerebras CS-4 tarafında üç WSE-3T hızlandırıcının her biri 44 GB SRAM içeriyor ve toplam kapasite 132 GB seviyesine ulaşıyor. Daha yüksek bellek kapasitesi sisteme ek hareket alanı sağlasa da aynı senaryoda yaklaşık 12 istemlik sınır ortaya çıkıyor. Buradaki temel sorun işlem gücünün yetersiz kalması değil, büyük miktarda bağlam bilgisinin hızlandırıcı belleğinde tutulmasının sistemi ölçeklendirmeyi zorlaştırması oluyor.
Yapay zekâ çıkarımı için donanım seçimi, üretim ortamlarında hız ile kapasite arasında denge kurulmasını gerektiriyor. Nvidia’nın GPU mimarileri yüksek toplam işlem hacmi isteyen görevlerde güçlü bir seçenek sunarken Groq’un LPU mimarisi ile Cerebras’ın wafer-scale yaklaşımı özellikle düşük gecikmeli token üretiminde avantaj sağlayabiliyor. Böyle bir yapı, bütün iş yükünü tek bir işlemci türüne yüklemek yerine farklı donanımları görevlerine göre konumlandıran heterojen hesaplama modeline dayanıyor.
Nvidia’nın Groq teknolojisi için 20 milyar dolarlık lisans anlaşmasına yönelmesi, şirketin düşük gecikmeli çıkarım tarafındaki yaklaşımını da ortaya koyuyor. AWS ile Cerebras arasındaki iş birliği de benzer şekilde özel hızlandırıcıların büyük bulut altyapılarıyla birlikte kullanılabileceğini gösteriyor. Amazon’un Trainium ailesi gibi alternatif hızlandırıcılar da aynı pazarın farklı ihtiyaçlara göre çeşitlendiğini ortaya koyuyor.
Bir decode hızlandırıcısı model ağırlıklarını üzerinde tutarak token üretiminin kritik bölümünü üstlendiğinde GPU üzerindeki bazı bellek ve işlem yükleri azaltılabiliyor. Bu yaklaşım, özellikle çok kullanıcılı servislerde özel hızlandırıcıların tek başına kullanılmasına kıyasla daha dengeli bir sistem tasarımı sağlayabiliyor. Dolayısıyla Nvidia ile Cerebras’ın açıkladığı en yüksek değerler yerine GPU ile özel hızlandırıcının birlikte çalıştığı gerçek üretim senaryoları daha anlamlı bir karşılaştırma sunacak.
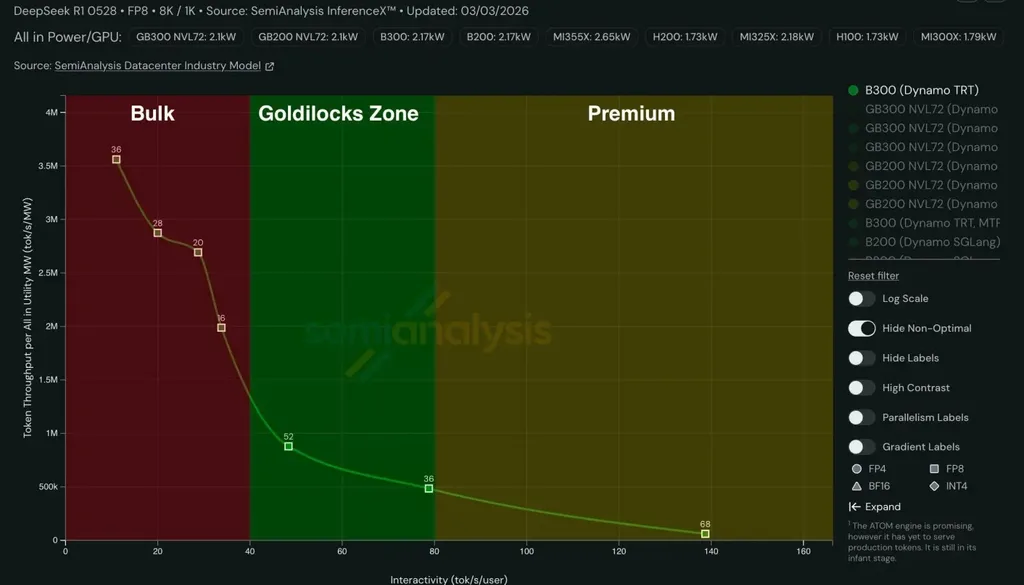
Yapay zekâ çıkarım performansı için daha kapsamlı değerlendirme, yalnızca en yüksek token hızını değil farklı kullanıcı yoğunluklarındaki gecikme, kapasite ve maliyet dengesini de ölçüyor. SemiAnalysis tarafından geliştirilen InferenceX yaklaşımı, sistemleri tek bir çalışma noktası üzerinden değerlendirmek yerine Pareto eğrisi boyunca farklı performans seviyelerinde karşılaştırıyor. Böylece yüksek hacimli düşük etkileşimli iş yükleri ile ultra düşük gecikme isteyen premium çıkarım senaryoları aynı değerlendirme içerisinde görülebiliyor.
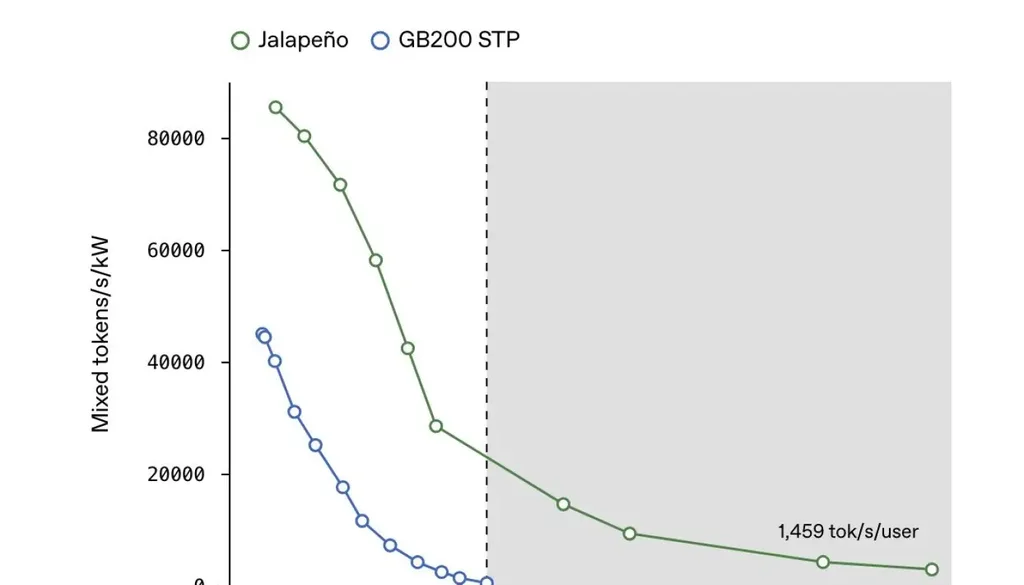
OpenAI’ın yeni Jalapeño hızlandırıcılarını tanıtırken InferenceX sonuçlarını kullanması da farklı bir ölçüm yaklaşımını öne çıkardı. OpenAI tarafından paylaşılan sonuçlar, özel hızlandırıcının Nvidia’nın Blackwell GB200 sistemleri karşısındaki davranışını yalnızca tek bir test noktası üzerinden değil farklı çıkarım koşulları altında incelemeye olanak sağlıyor.
Sektördeki sonraki karşılaştırmaların Nvidia GPU’ları, AMD platformları, Groq LPUs ve Cerebras CS-4 gibi bileşenlerin birlikte çalıştığı sistemlere odaklanması bekleniyor. Kurumsal yapay zekâ hizmetlerinde gerçek avantaj, en yüksek token hızını yakalamaktan çok aynı enerji bütçesi ile daha fazla kullanıcıya istikrarlı hizmet sunabilen mimaride ortaya çıkacak. Türkiye’de yapay zekâ altyapısına yatırım yapan işletmeler açısından da donanım seçiminde yalnızca üretici tarafından açıklanan zirve performansına değil eşzamanlı kullanıcı kapasitesi, bellek ihtiyacı, enerji tüketimi ve token başına maliyet gibi ölçütlere bakılması daha sağlıklı bir yatırım hesabı sağlayacak.