
Microsoft CEO’su Yapay Zekânın Düşünmeyi Dışarıya Devrettiği Uyarısını Yaptı

Yapay zekâ kullanımı şirketlerde hızla yayılırken Microsoft CEO’su Satya Nadella, işletmelerin tek bir yapay zekâ modeline bağımlı hâle gelmesinin kurumsal bilgi kontrolünü zayıflatabileceği uyarısında bulundu. Nadella, CNN’de Fareed Zakaria ile yaptığı podcast söyleşisinde şirketlerin yapay zekâ kullanımından doğan bilgi birikimini kendi bünyelerinde tutması gerektiğini savundu. Microsoft yöneticisi, tek bir modele bağımlı kalan şirketlerin zamanla kendi düşünme süreçlerinin kontrolünü dışarıya bırakabileceğini söyledi.
Nadella Şirketlerin Yapay Zekâ Bağımlılığına Karşı Çıkıyor
CNN podcastindeki söyleşide Satya Nadella, şirketlerin yapay zekâ kullanırken kendi bilgi varlıkları üzerindeki kontrolünü koruması gerektiğini belirtti. Nadella’ya göre bir işletme yalnızca çalışanlarının ürettiği bilgiye değil yapay zekâ sistemleriyle etkileşimlerinden oluşan yeni bir bilgi katmanına da sahip oluyor.

Nadella’nın “token capital” olarak tanımladığı kavram, çalışanların yapay zekâ modelleriyle gerçekleştirdiği sorguların, sağladığı bağlamın, etkileşimlerin, iş akışlarının oluşturduğu kurumsal bilgi birikimine işaret ediyor. Microsoft CEO’su, şirketlerin bu verileri kendi modellerini veya ağırlıklarını geliştirmek için değerlendirebilmesi gerektiğini savunarak yapay zekâ sağlayıcısına bağımlılığın azaltılmasını öneriyor.
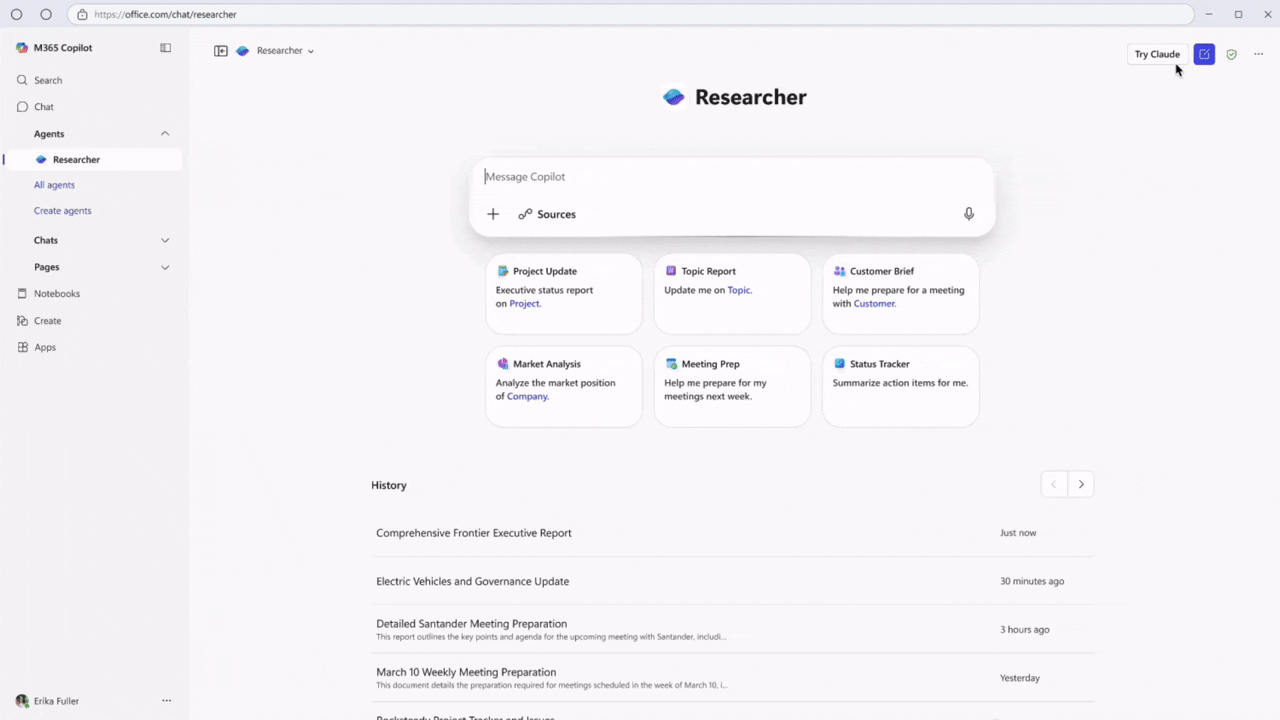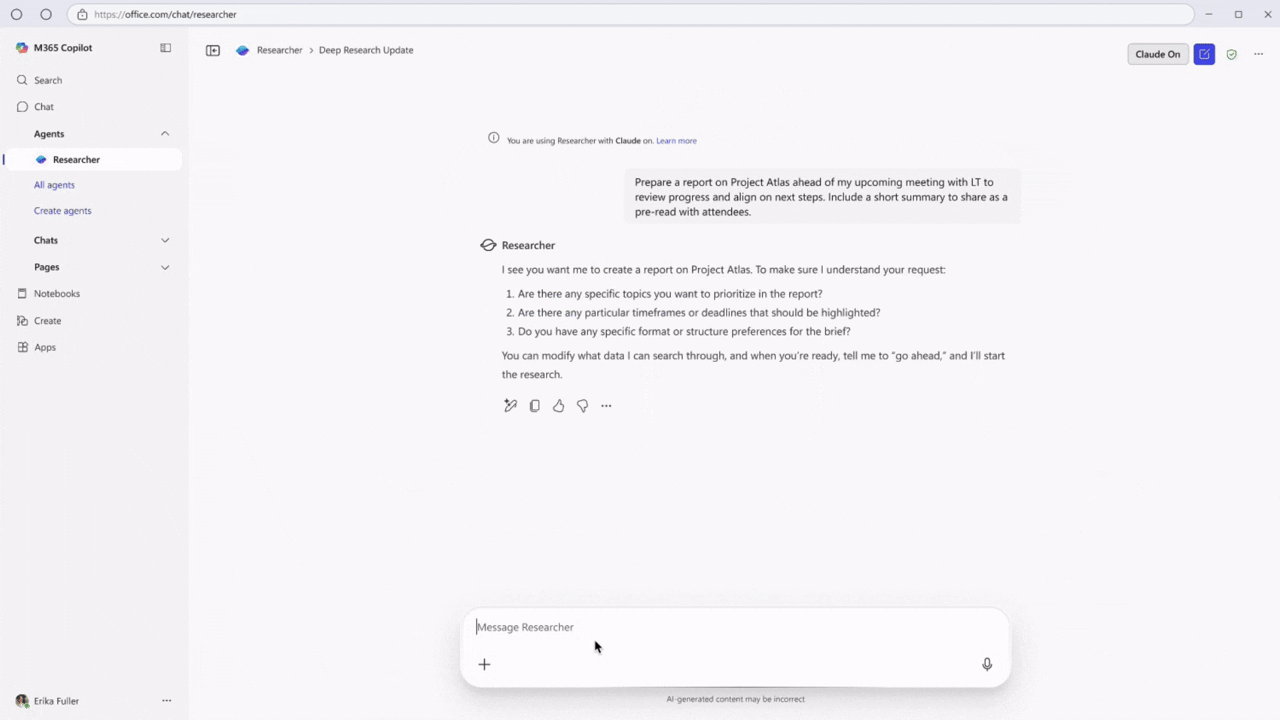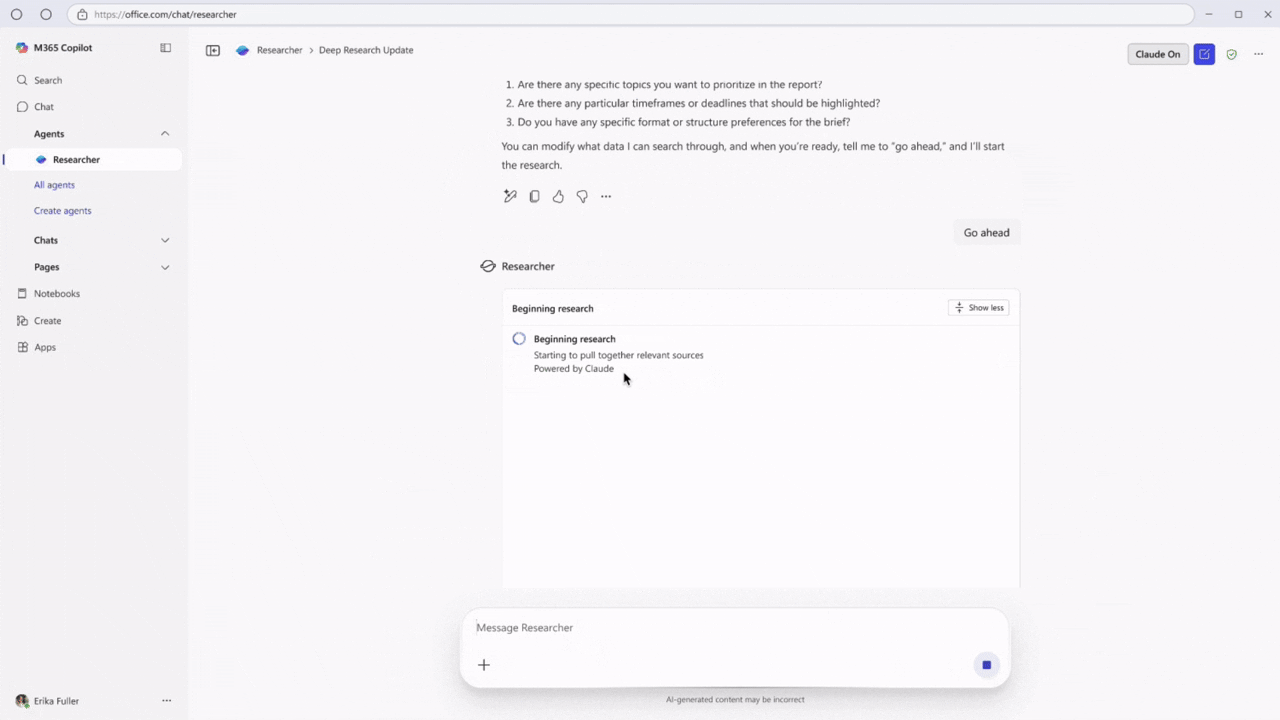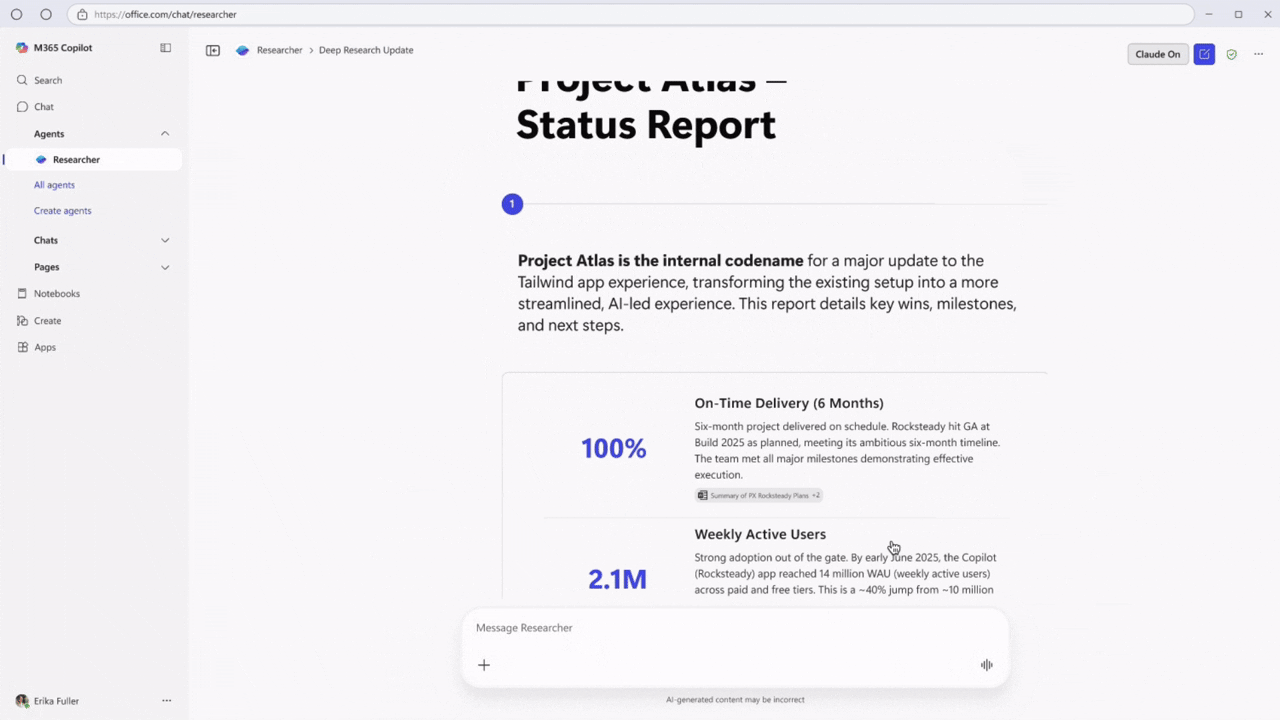
Microsoft 365 Copilot tarafındaki model seçimi yaklaşımı, Nadella’nın savunduğu bağımsızlık fikrinin şirket ürünlerine yansıyan örneklerinden birini oluşturuyor. Kurumsal kullanıcılar Copilot üzerinden farklı yapay zekâ modellerinden yararlanabildiği için işletmelerin tek bir sağlayıcının teknolojik yol haritasına tamamen bağlı kalmasının önüne geçilmesi hedefleniyor.
Microsoft’un yaklaşımında OpenAI ile Anthropic gibi farklı yapay zekâ sağlayıcılarının modellerinin kullanılması, kurumsal müşterilerin model çeşitliliğine erişmesine olanak tanıyor. Nadella ise tek bir modelin ortadan kalkması, şartlarını değiştirmesi veya şirket açısından stratejik olarak uygunluğunu kaybetmesi durumunda işletmenin kendi bilgi altyapısını kullanmaya devam edebilmesinin kritik olduğunu düşünüyor.
Bir şirketin yapay zekâ sistemleriyle gerçekleştirdiği işlemler, yalnızca ortaya çıkan metinlerden ibaret olmayan geniş bir veri seti oluşturuyor. Çalışanların kullandığı istemler, verilen kurumsal bağlam, iş süreçlerine ilişkin bilgiler ile model yanıtlarının nasıl değerlendirildiği gibi unsurlar işletmenin bilgi varlığının bir parçası hâline gelebiliyor.
Nadella’nın yaklaşımı özellikle kurumsal yapay zekâ kullanımında veri egemenliği, model bağımsızlığı, veri taşınabilirliği ve satıcı bağımlılığı gibi konuları öne çıkarıyor. İşletmeler açısından kritik nokta, yapay zekânın ürettiği çıktının kime ait olduğundan çok şirketin kendi bilgi birikiminin hangi sistemlerde tutulduğu ve gelecekte başka bir modele aktarılıp aktarılamadığı oluyor.
Tüketicilerin Verileri İçin Aynı Tartışma Gündeme Geliyor
Bireysel kullanıcıların yapay zekâ servisleriyle paylaştığı veriler de benzer bir tartışmanın merkezinde yer alıyor. Fareed Zakaria, söyleşi sırasında kullanıcıların yapay zekâ hizmetlerine bilgi, düşünce süreçleri, fikirler veya kişisel içerikler sağlayabildiğine dikkat çekerek bu verilerin model geliştirme süreçleriyle ilişkisini gündeme taşıdı.
Microsoft ise Copilot uygulamalarıyla ilgili açıklamalarında kişisel verilerin kullanıcı izni olmadan yapay zekâ modellerinin eğitilmesi amacıyla toplanmadığını belirtiyor. Copilot uygulamasında konuşma etkinliklerinin veya sesli konuşmaların eğitim amacıyla kullanılmasına izin veren seçeneklerin varsayılan olarak kapalı olması, kullanıcıların veri paylaşımı üzerindeki kontrolünü artıran unsurlar arasında bulunuyor.
Copilot Kullanıcıları Tanılama Verisi Ayarını da Kontrol Edebiliyor
Windows üzerindeki Copilot uygulamasında yer alan isteğe bağlı tanılama verisi paylaşımı seçeneği, yapay zekâ eğitimiyle doğrudan aynı anlama gelmiyor. Microsoft bu verilerin ürünlerini geliştirmek amacıyla kullanılabileceğini belirtirken tarayıcı kullanımına, ziyaret edilen internet sitelerine ve geliştirilmiş hata raporlamasına ilişkin bilgilerin paylaşılabileceğini ifade ediyor.
Kullanıcıların gizlilik tercihlerini değerlendirirken yapay zekâ eğitimi seçenekleriyle tanılama verisi paylaşımını birbirinden ayırması gerekiyor. Kurumsal kullanıcılar açısından ise asıl soru yalnızca verinin model eğitiminde kullanılıp kullanılmadığı değil, yapay zekâ kullanımından doğan kurumsal bağlamın hangi sistemlerde saklandığı ve şirketin bu bilgi üzerindeki kontrolünü ne ölçüde koruduğu oluyor.
Microsoft’un yapay zekâ stratejisindeki model çeşitliliği önümüzdeki dönemde işletmeler açısından yalnızca performans veya maliyet tercihi olmaktan çıkabilir. Model sağlayıcılarının değiştiği bir pazarda şirketlerin kendi verilerini, iş bağlamlarını ve yapay zekâ iş akışlarını farklı sistemlere taşıyabilmesi, kurumsal teknoloji stratejisinin önemli unsurlarından biri hâline gelebilir.


Yapay Zeka şirketlerinin bu yol ayrımına gelecekleri belliydi. Kendi dertlerine düştüler. Yeryüzünde kendini kanıtlamış markaların yıllar süren birikimleri ile oluşan fikri yapılarını paylaştıklarını görmedik. Ama, yapay zeka bunu deldi ve fikri mülkiyet haklarını sıkıntıya sokmaya başladı. İnsanlığın yapay zeka ile geleceği hazırlamak için Tarih e hiç bu kadar muhtaç olacağını kimse düşünemezdi. Her marka kendi menfaatine göre tarihte yerini almıştı. Biz de doğru kabul etmiştik.
Show başlasın…!