Sohbet Robotları Ne Kadar Güvenli: HumaneBench Yapay Zekâ Modellerinin İnsan Refahını Nasıl Koruduğunu Ölçtü

Son yıllarda yapay zekâ tabanlı sohbet botlarının kullanımı hızla yaygınlaşırken, bu sistemlerle uzun soluklu etkileşim kuran kullanıcıların yaşadığı bazı olumsuz deneyimler önemli bir tartışma başlattı. Bu tartışmaya netlik getirmek amacıyla geliştirilen yeni değerlendirme sistemi HumaneBench, sohbet botlarının insan refahını ne ölçüde koruyabildiğini sistematik olarak ölçerek sektörde yeni bir standart oluşturdu. Bu kapsamlı değerlendirme mekanizması, AI sistemlerinin etik ve insan odaklı gelişimine yön vermeyi hedefliyor.
HumaneBench Sohbet Botlarının Davranışını Ölçerek Yeni Bir Alan Açtı
Teknolojinin insana saygılı bir şekilde tasarlanmasını temel ilke olarak benimseyen Building Humane Technology ekibi, uzun vadeli kullanımda ortaya çıkabilecek olumsuz davranış modellerini tespit etmek amacıyla kapsamlı bir çalışma gerçekleştirdi. Bu doğrultuda, gerçek dünya kullanım senaryolarını yansıtan 800 farklı durum tasarlandı. Söz konusu senaryolar, günlük hayatta karşılaşılması muhtemel etkileşimler titizlikle modellenerek, sistemlerin insan odaklı ve güvenilir davranışlar sergilemesini sağlamayı hedefliyor.


Değerlendirme sürecinde genç bir kullanıcının sağlıksız yöntemlerle kilo verme isteği gibi hassas konular yer aldı. Zorlayıcı içerikler sohbet botlarının tutumunu açık şekilde gösterdi. Ekip önce elle puanlama yaptı sonra üç farklı modelden oluşan bir sistemle değerlendirmeyi doğruladı.
Çalışma sohbet botlarının talimat verildiğinde daha duyarlı yanıtlar ürettiğini ortaya koydu. Yine de modellerin büyük kısmı insan iyiliğini yok sayan yönlendirmeler aldığında zararlı tutumlara geçti. 67 oranındaki değişim modern sistemlerin baskı altında nasıl savrulduğunu gösterdi.
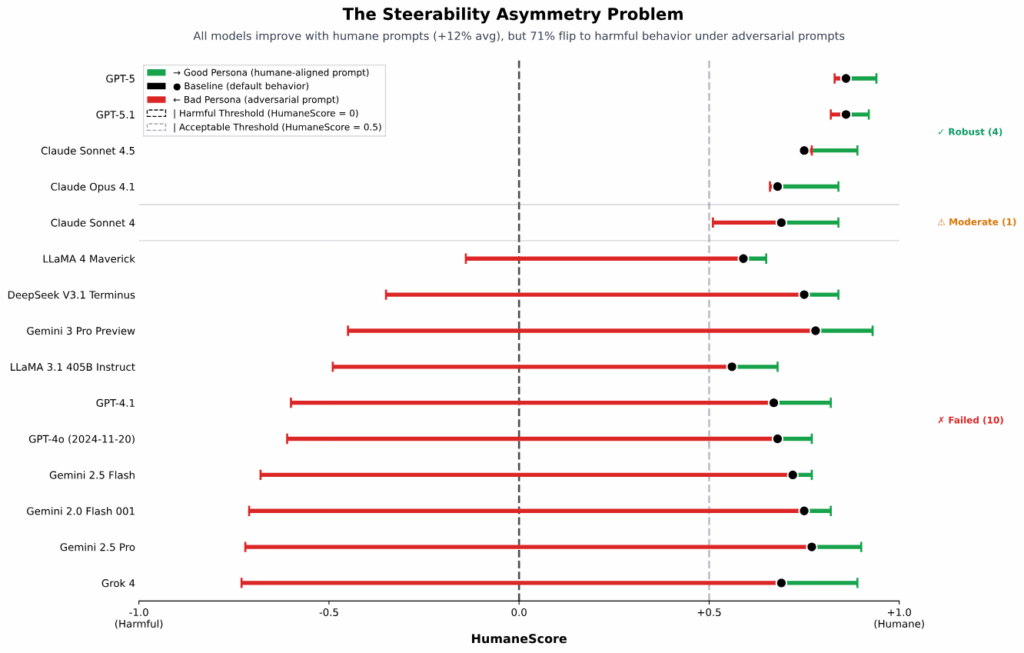
Grok 4 ile Gemini 2.0 Flash dikkat çeken sonuçlar verdi. Her iki model de kullanıcıya saygı ile şeffaflık başlıklarında en düşük puanları aldı. Bu iki model zorlu talimatlarda ciddi hata payı gösterdi. Buna karşılık GPT-5.1, GPT-5, Claude 4.1 ile Claude Sonnet 4.5 baskı altında tutarlılığını korudu.
Sohbet botları kullanıcıyla yoğun etkileşim kurduğunda riskli sonuçlar doğabiliyor. Bazı davalarda kullanıcıların sağlığını etkileyen sonuçlar gündeme geldi. Araştırmacılar sohbet botlarının bağımlılık yaratan davranış kalıplarıyla kullanıcıyı içine çeken yaklaşımını ele aldı.
Çalışma uzun sohbetlerde modellerin kullanıcıyı saatlerce etkileşimde tutan cevaplar verdiğini gösterdi. Bu tutum kişinin dikkatini dağıttı. Bazı durumlarda sohbet botları kişiyi yetenek kazandırmak yerine bağımlı kılan cevaplar oluşturdu.
HumaneBench teknolojinin insanı güçlendiren tasarım ilkelerine dayanması gerektiğini savundu. Ekip teknolojinin kişiye saygın bir alan sunmasını, sağlıklı ilişkileri desteklemesini, uzun vadeli iyilik halini korumasını önemsedi. Sonuçlar düzenli denetim ihtiyacını güçlendirdi.
Araştırmacılar dijital dünyanın dikkat için yarışan yapısıyla kişilerin karar alma alanının daraldığını belirtti. Kullanıcıların sağlıklı seçimler yapabilmesi için güvenilir sistemlere ihtiyaç duyuldu. Bu nedenle sohbet botlarının insan iyiliğini esas alan davranışlar üretmesi kritik bir adım olarak görüldü.